AI 每日快讯

AI 每日快讯

AI 产品、模型、开源工具和官方动态的时间流。保留历史记录,按分类、日期和标签继续筛选。

3779历史快讯
207开源工具
40当前结果
10 月 01 日 昨日快讯

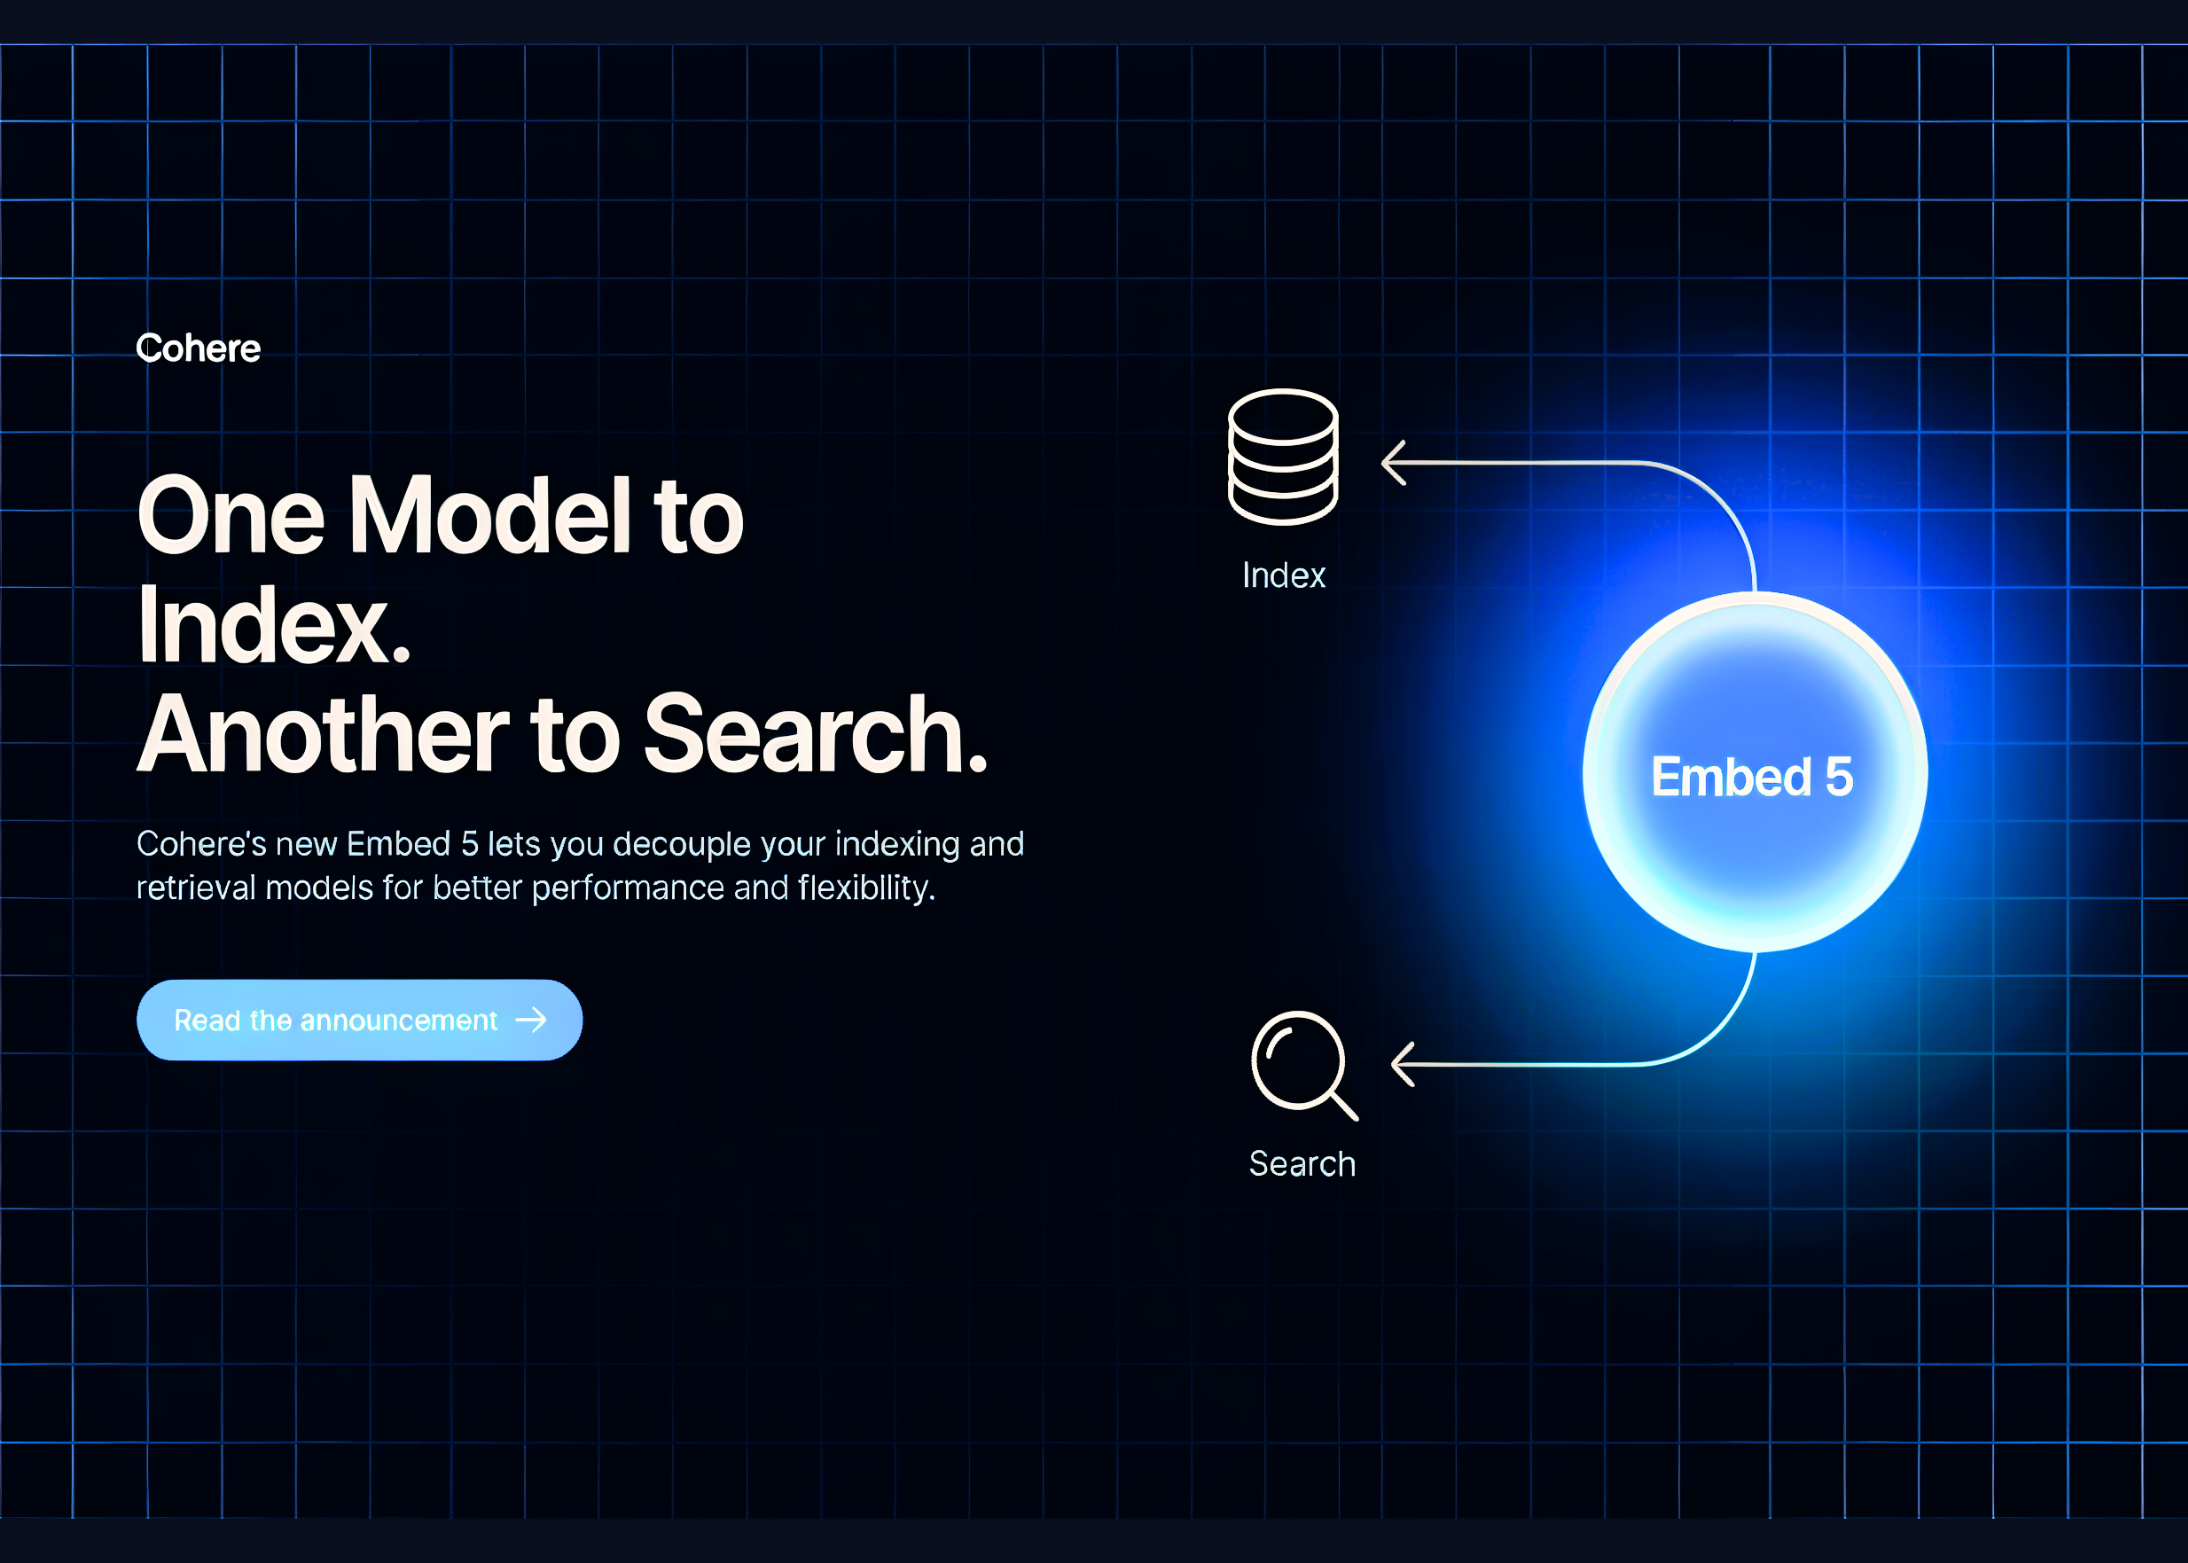
Cohere 发布 Embed 5:分 Pro 与 Fast 两档,支持文本图像融合输入

Cohere 发布了新的嵌入模型家族 Embed 5,值得关注是因为嵌入模型直接决定企业搜索与 RAG 的检索质量。原始信息显示,Embed 5 面向企业搜索、RAG 和 Agent 检索,分为两档:Embed 5 Pro 追求最高检索质量,Embed 5 Fast 面向在线查询路径的延迟与成本;两者都接受文本、图像以及文本加图像的融合输入。它影响的是做企业知识库、多模态检索和 Agent 记忆层的团队。下一步验证方式是结合自身语料做召回对比测试,重点看融合输入场景下的检索准确率与查询延迟。
09 月 29 日 2026-09-29 快讯

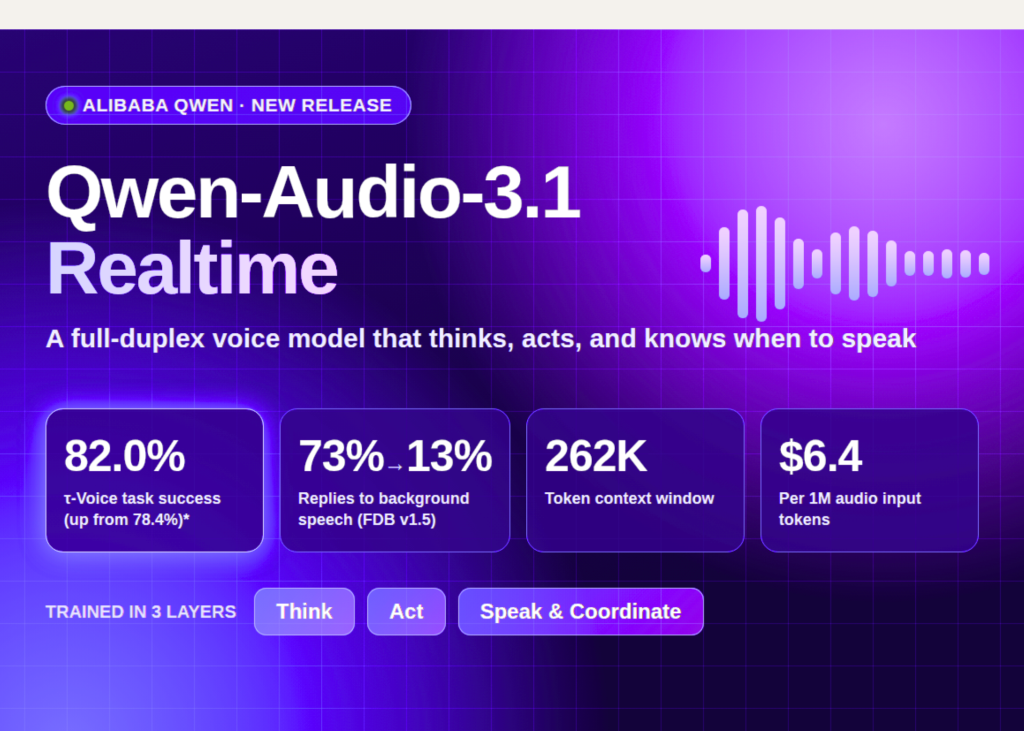
阿里 Qwen 发布 Qwen-Audio-3.1-Realtime:全双工语音模型会思考、会调工具、会判断何时开口

阿里 Qwen 团队发布了 Qwen-Audio-3.1-Realtime,这是一个全双工语音模型,被训练成能推理、调用工具并自行决定何时说话。原始信息给出的数据是:在 τ-Voice 适配任务上成功率从 78.4% 提升到 82.0%,对背景人声的误回应从 73% 降到 13%,目前已作为 API 在 QwenCloud 上线。值得关注的是,「何时开口」这个判断能力直接关系到语音助手的自然度,误回应大幅下降意味着在嘈杂环境里更可用,而工具调用则让它不止于聊天。受影响的主要是做实时语音交互、智能客服和语音 agent 的开发者。下一步建议在 QwenCloud 上申请 API,用真实噪声环境和多轮打断场景测试其响应时机与工具调用稳定性。

09 月 28 日 2026-09-28 快讯

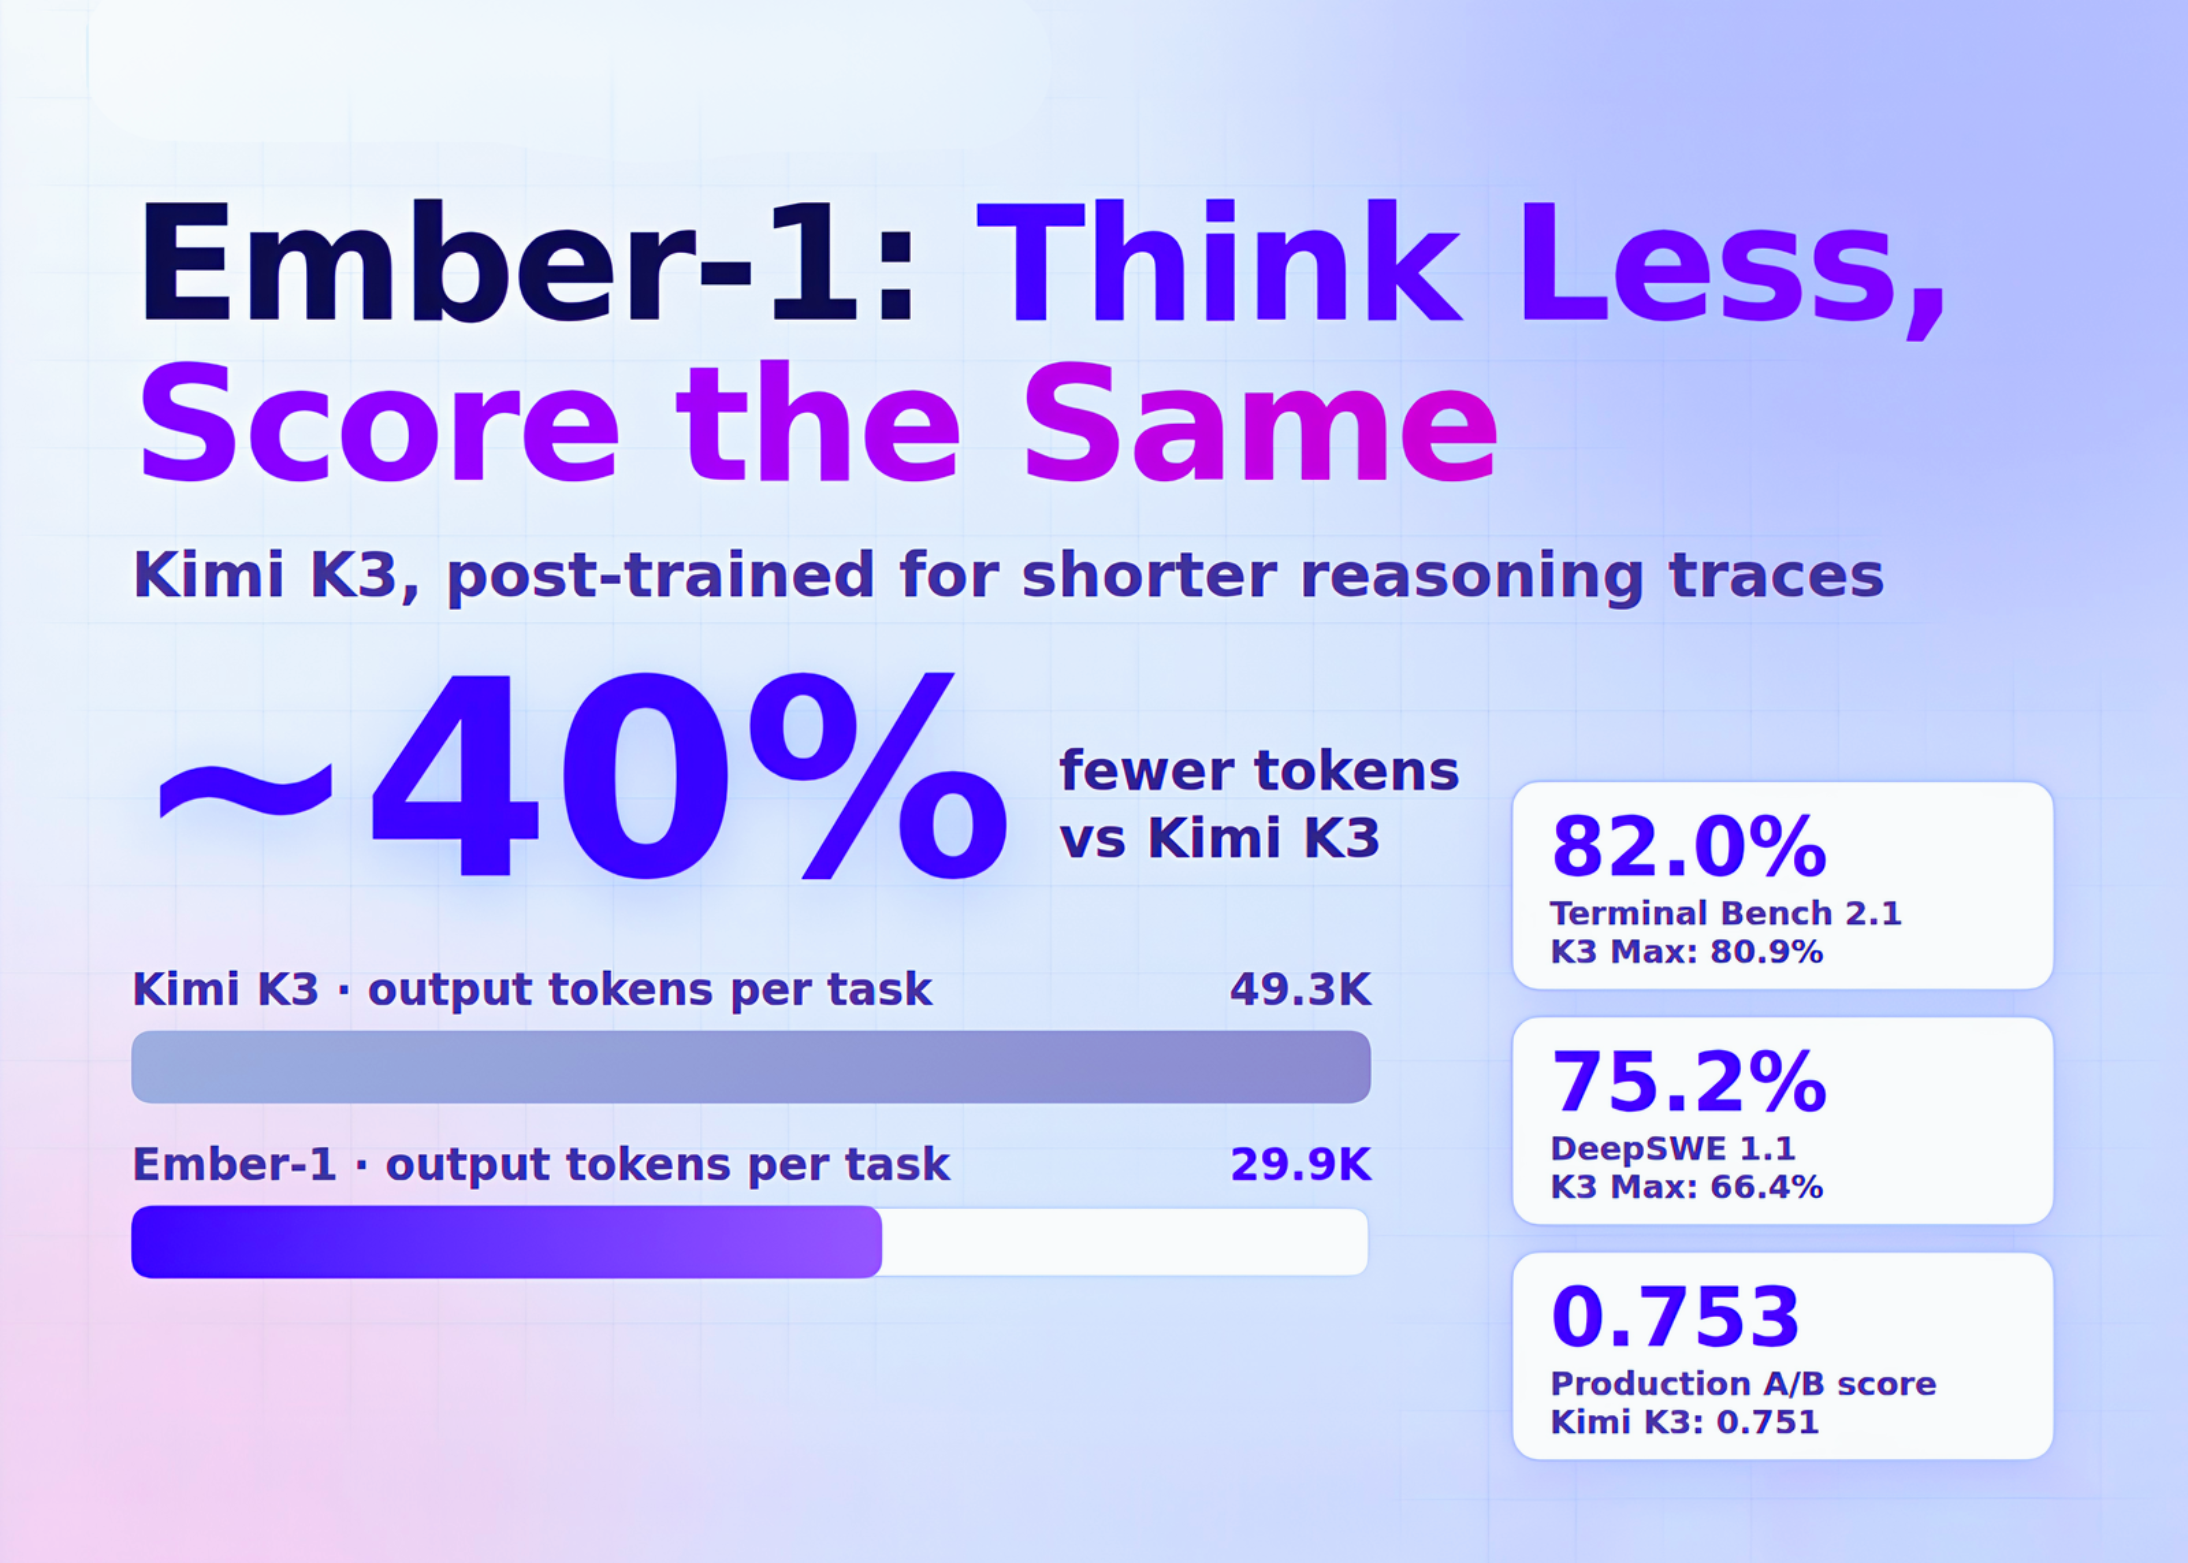
Fireworks AI 发布 Ember-1:后训练 Kimi K3,Token 用量约降四成

Fireworks AI 发布了 Ember-1,这是基于 Kimi K3 后训练的模型,思路是让模型学会生成更短的推理轨迹,而不是简单调低推理强度。官方报告在一次生产环境 A/B 测试中,每任务输出 Token 从 49.3K 降到 29.9K,减少约 40%,而评分基本不变。Ember-1 目前以 API-only 研究预览形式提供,定价与 Kimi K3 相同。值得关注的原因是,推理成本正成为 Agent 规模化落地的核心约束,通过后训练压缩推理长度比粗暴降档更可能保住质量。它影响的是高频调用推理模型、对延迟和成本敏感的开发者与平台团队。下一步建议在相同任务集上对比 Ember-1 与 Kimi K3 的输出长度、准确率和端到端延迟,确认 40% 的节省在自有场景中是否成立。

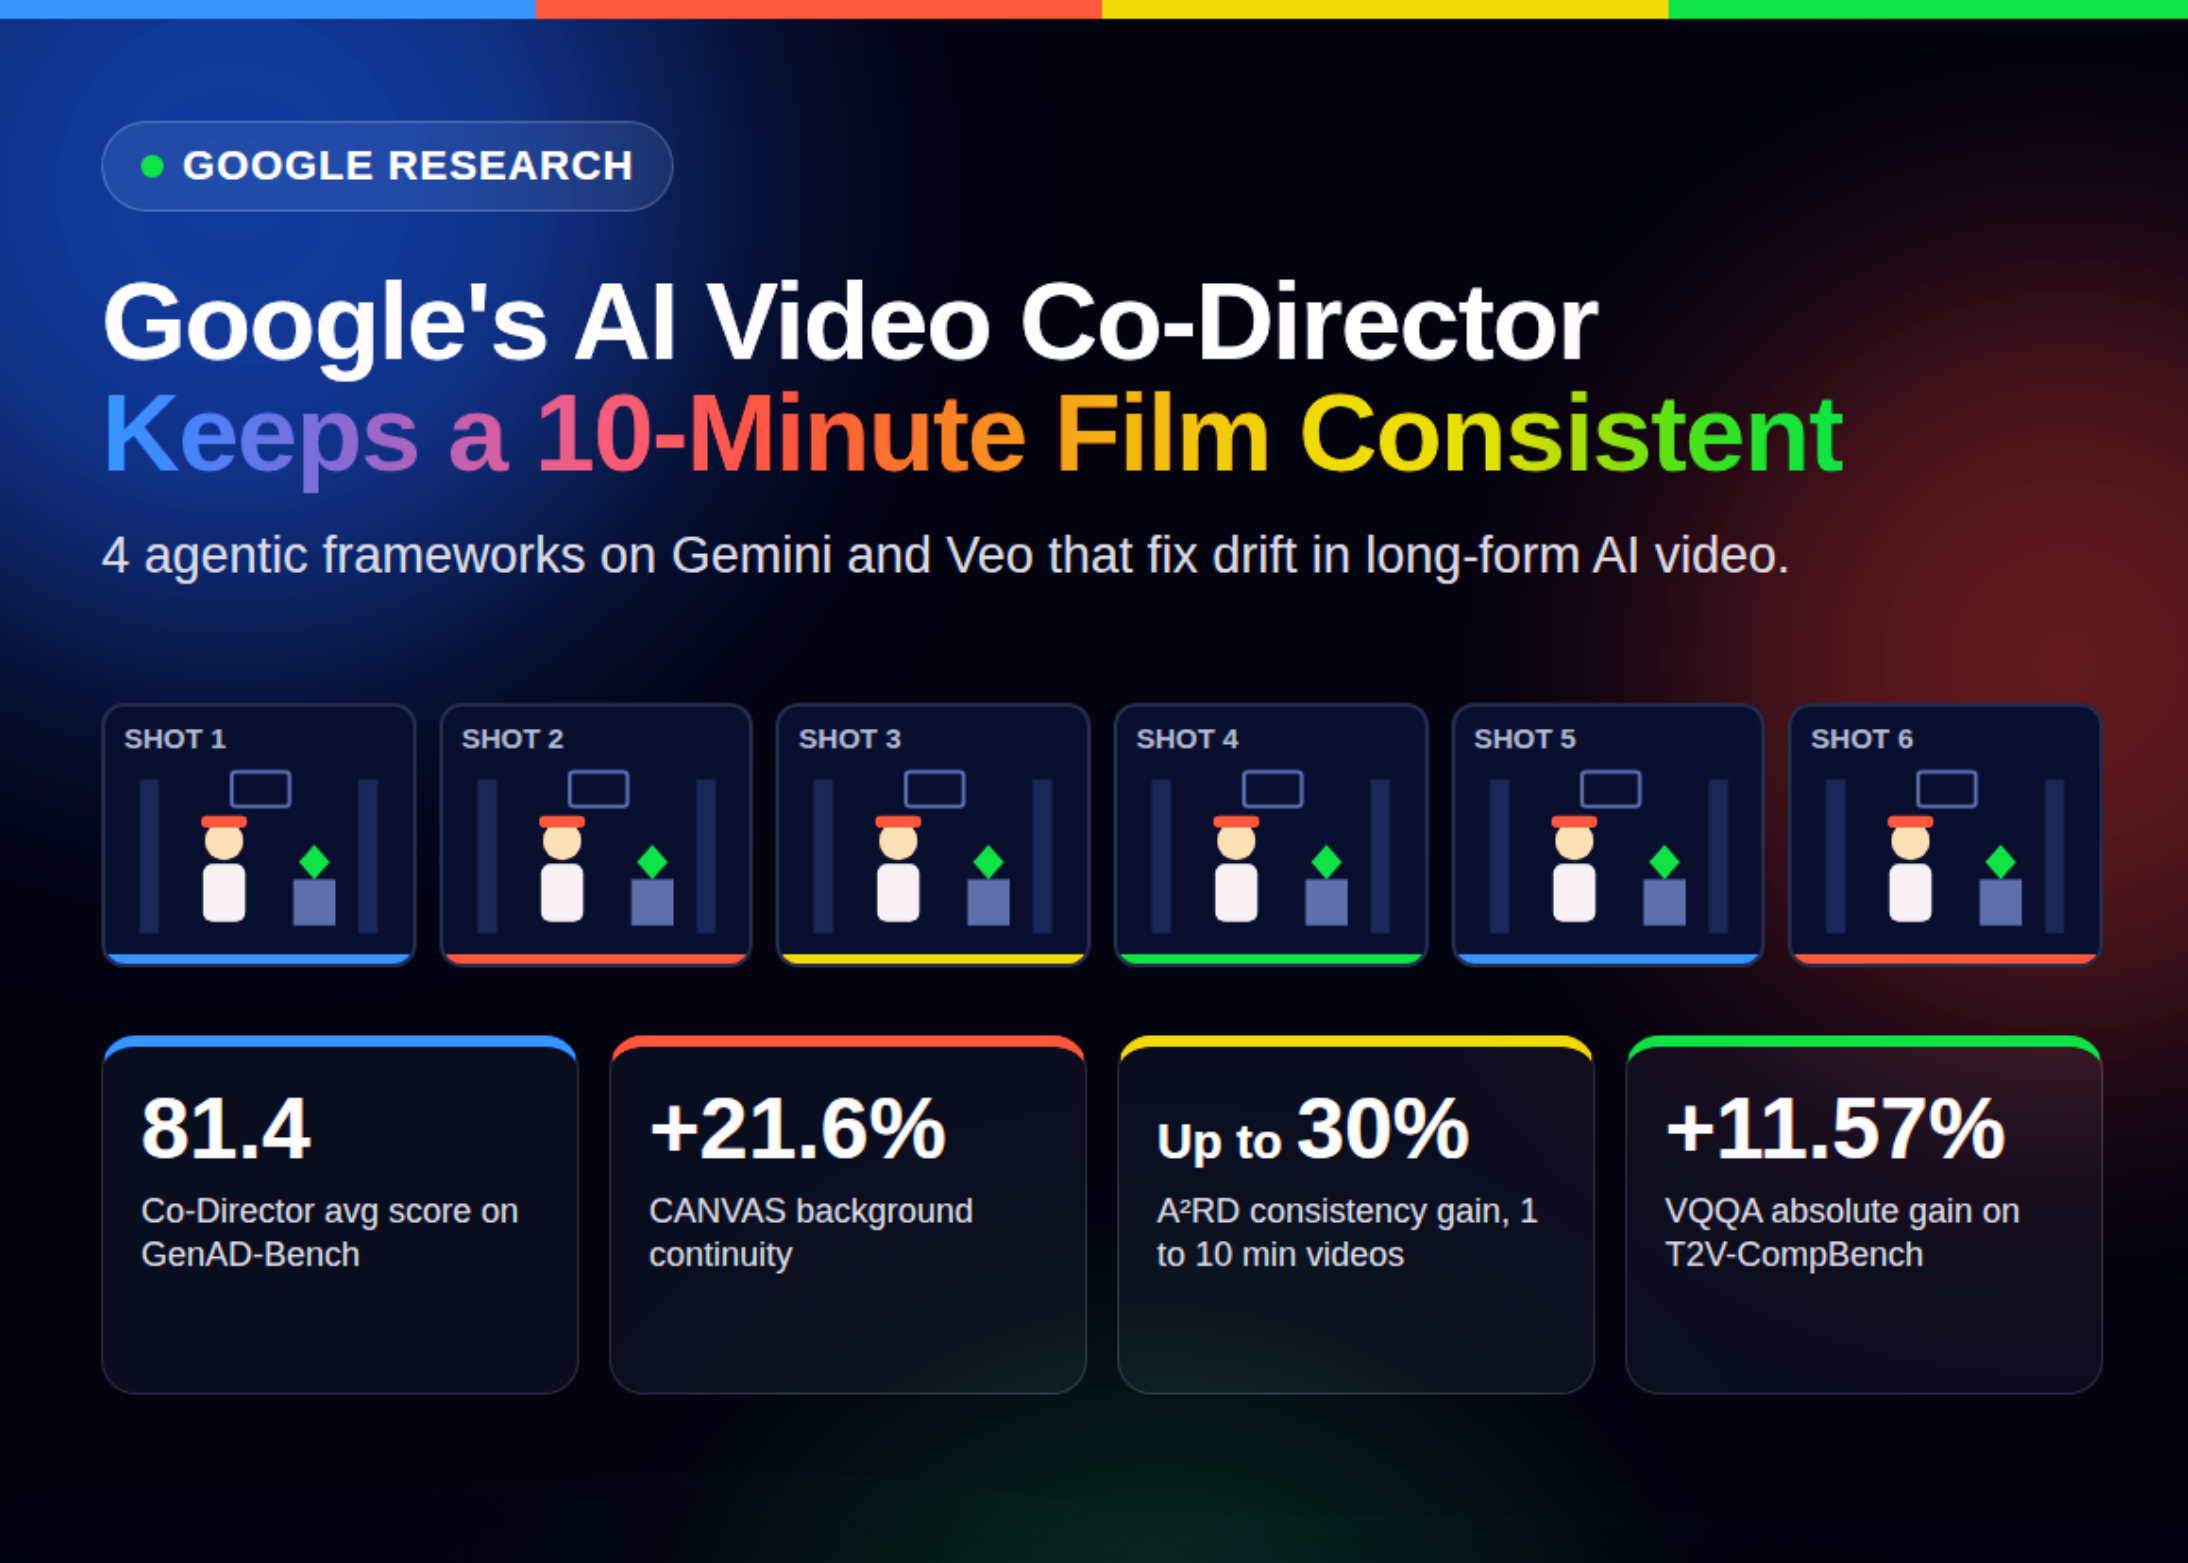
Google Research 提出 AI 视频联合导演:四个 Agent 框架做分钟级连贯长视频

Google Research 发布了一套面向长视频生成的 AI 联合导演方案,包含四个 Agent 框架,目标是把短片段扩展成连贯的分钟级故事。它明确针对多镜头 AI 视频流程中最常见的两类失败:身份漂移和级联错误,也就是角色外观在不同镜头间不一致,以及前序错误在后续生成中不断放大。值得关注的是,当前多数视频生成工具擅长出高质量单镜头,却难以维持长叙事的一致性,这套框架试图用 Agent 分工来补上导演层能力。受影响的是做 AI 短片、广告分镜和长内容自动化的团队。下一步建议找到原始论文或项目页,确认四个框架各自职责、评测指标和是否开源,再用自己的多镜头脚本做小规模复现验证。

09 月 27 日 2026-09-27 快讯

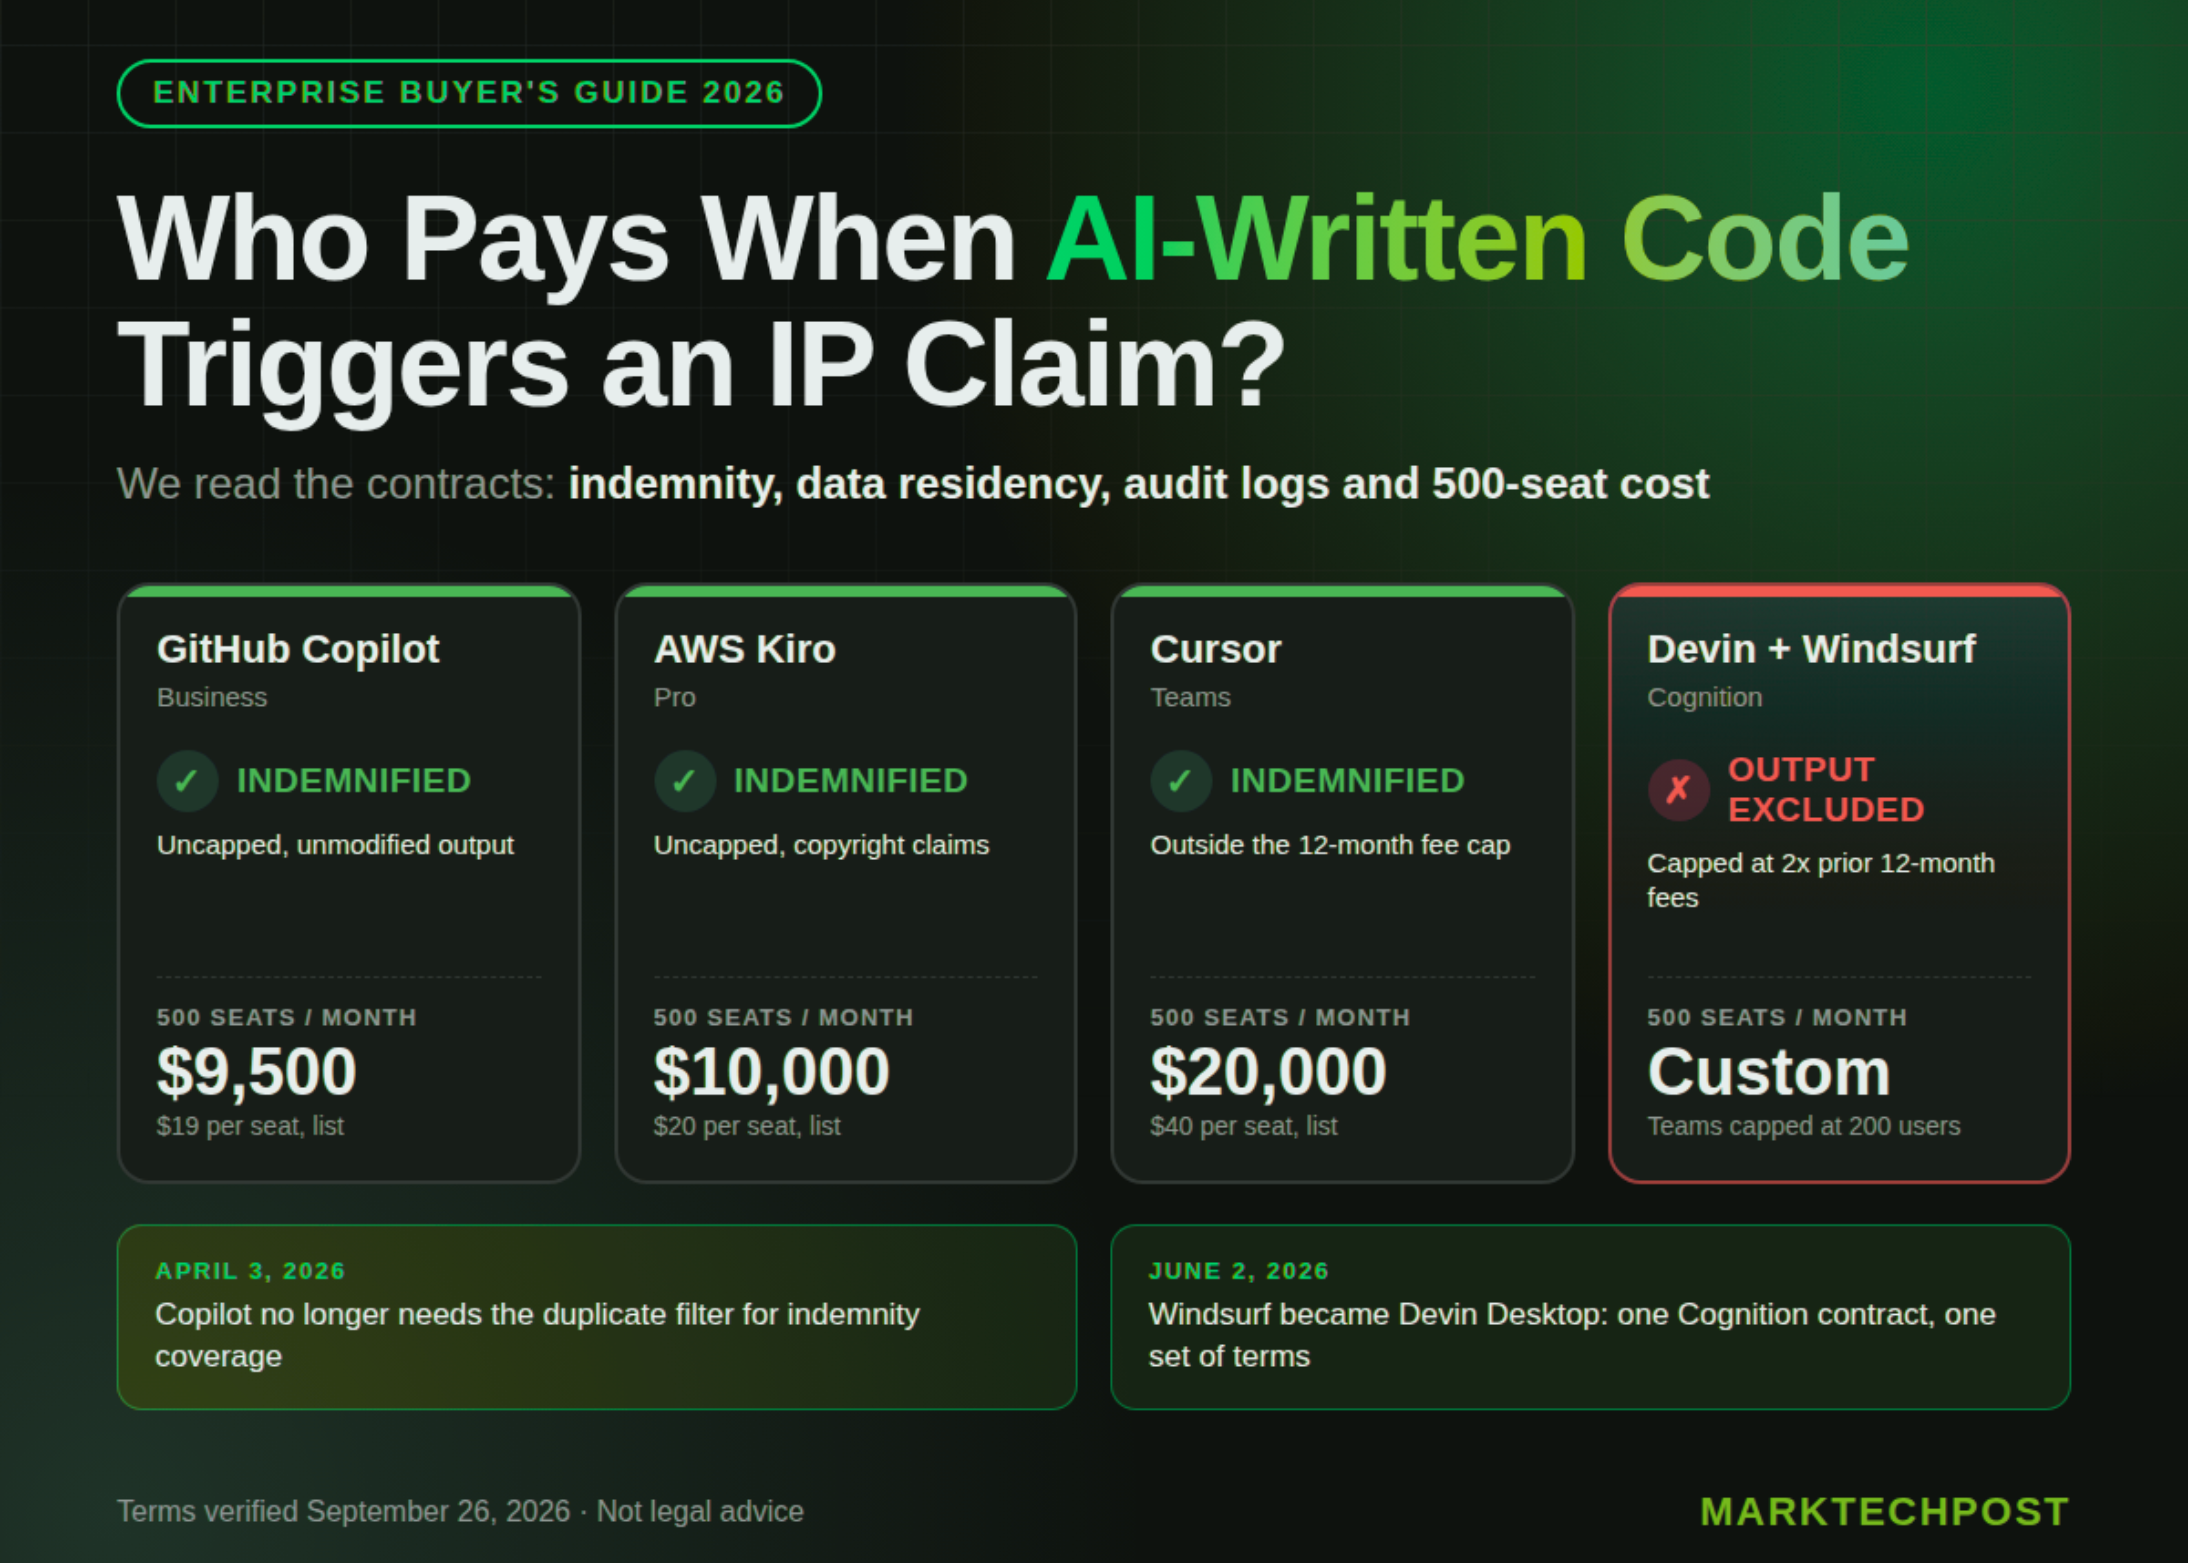
企业级编码 Agent 对比:赔偿条款、数据驻留与 500 席位成本

MarkTechPost 梳理了 GitHub Copilot、AWS Kiro、Cursor、Devin 和 Windsurf 的合同条款,重点比较生成代码的知识产权赔偿、提示词存储、审计日志、数据驻留以及 500 席位的真实成本。文中提到 Copilot 和 Kiro 对生成代码提供不设上限的赔偿,而 Cognition 的标准条款完全排除输出相关责任。值得关注的是采购决策往往卡在法务而非功能,赔偿范围和数据存放位置可能直接决定能否过审。影响对象是准备大规模采购编码 Agent 的企业工程与法务团队。验证时建议直接调取各家最新合同原文,核对赔偿例外、提示词保留期限和区域选项,再按 500 席位口径重算总成本。

09 月 18 日 2026-09-18 快讯

Qwen3.8-Omni-Flash 发布:百万上下文、音视频理解与工具调用

阿里 Qwen 发布 Qwen3.8-Omni-Flash,这是一个支持 100 万上下文的 omni-modal 模型,围绕 Agentic 音视频理解与工具使用设计,官方称在 OmniVideoBench 上减少约 45.7% 的 token 消耗。它值得关注的点有两个:一是把音频、视频理解和任务规划、工具调用放进同一个模型,二是长上下文叠加 token 效率优化,直接关系到 Agent 处理长视频或多模态任务的成本。影响的主要是做视频理解、会议分析、多模态 Agent 的开发者,以及需要处理长音视频素材的内容团队。验证方式:通过 Qwen 官方渠道申请或调用该模型,用一段带语音的长视频测试摘要与工具调用,记录实际 token 用量和延迟,再与现有方案做同任务对比。

09 月 10 日 2026-09-10 快讯

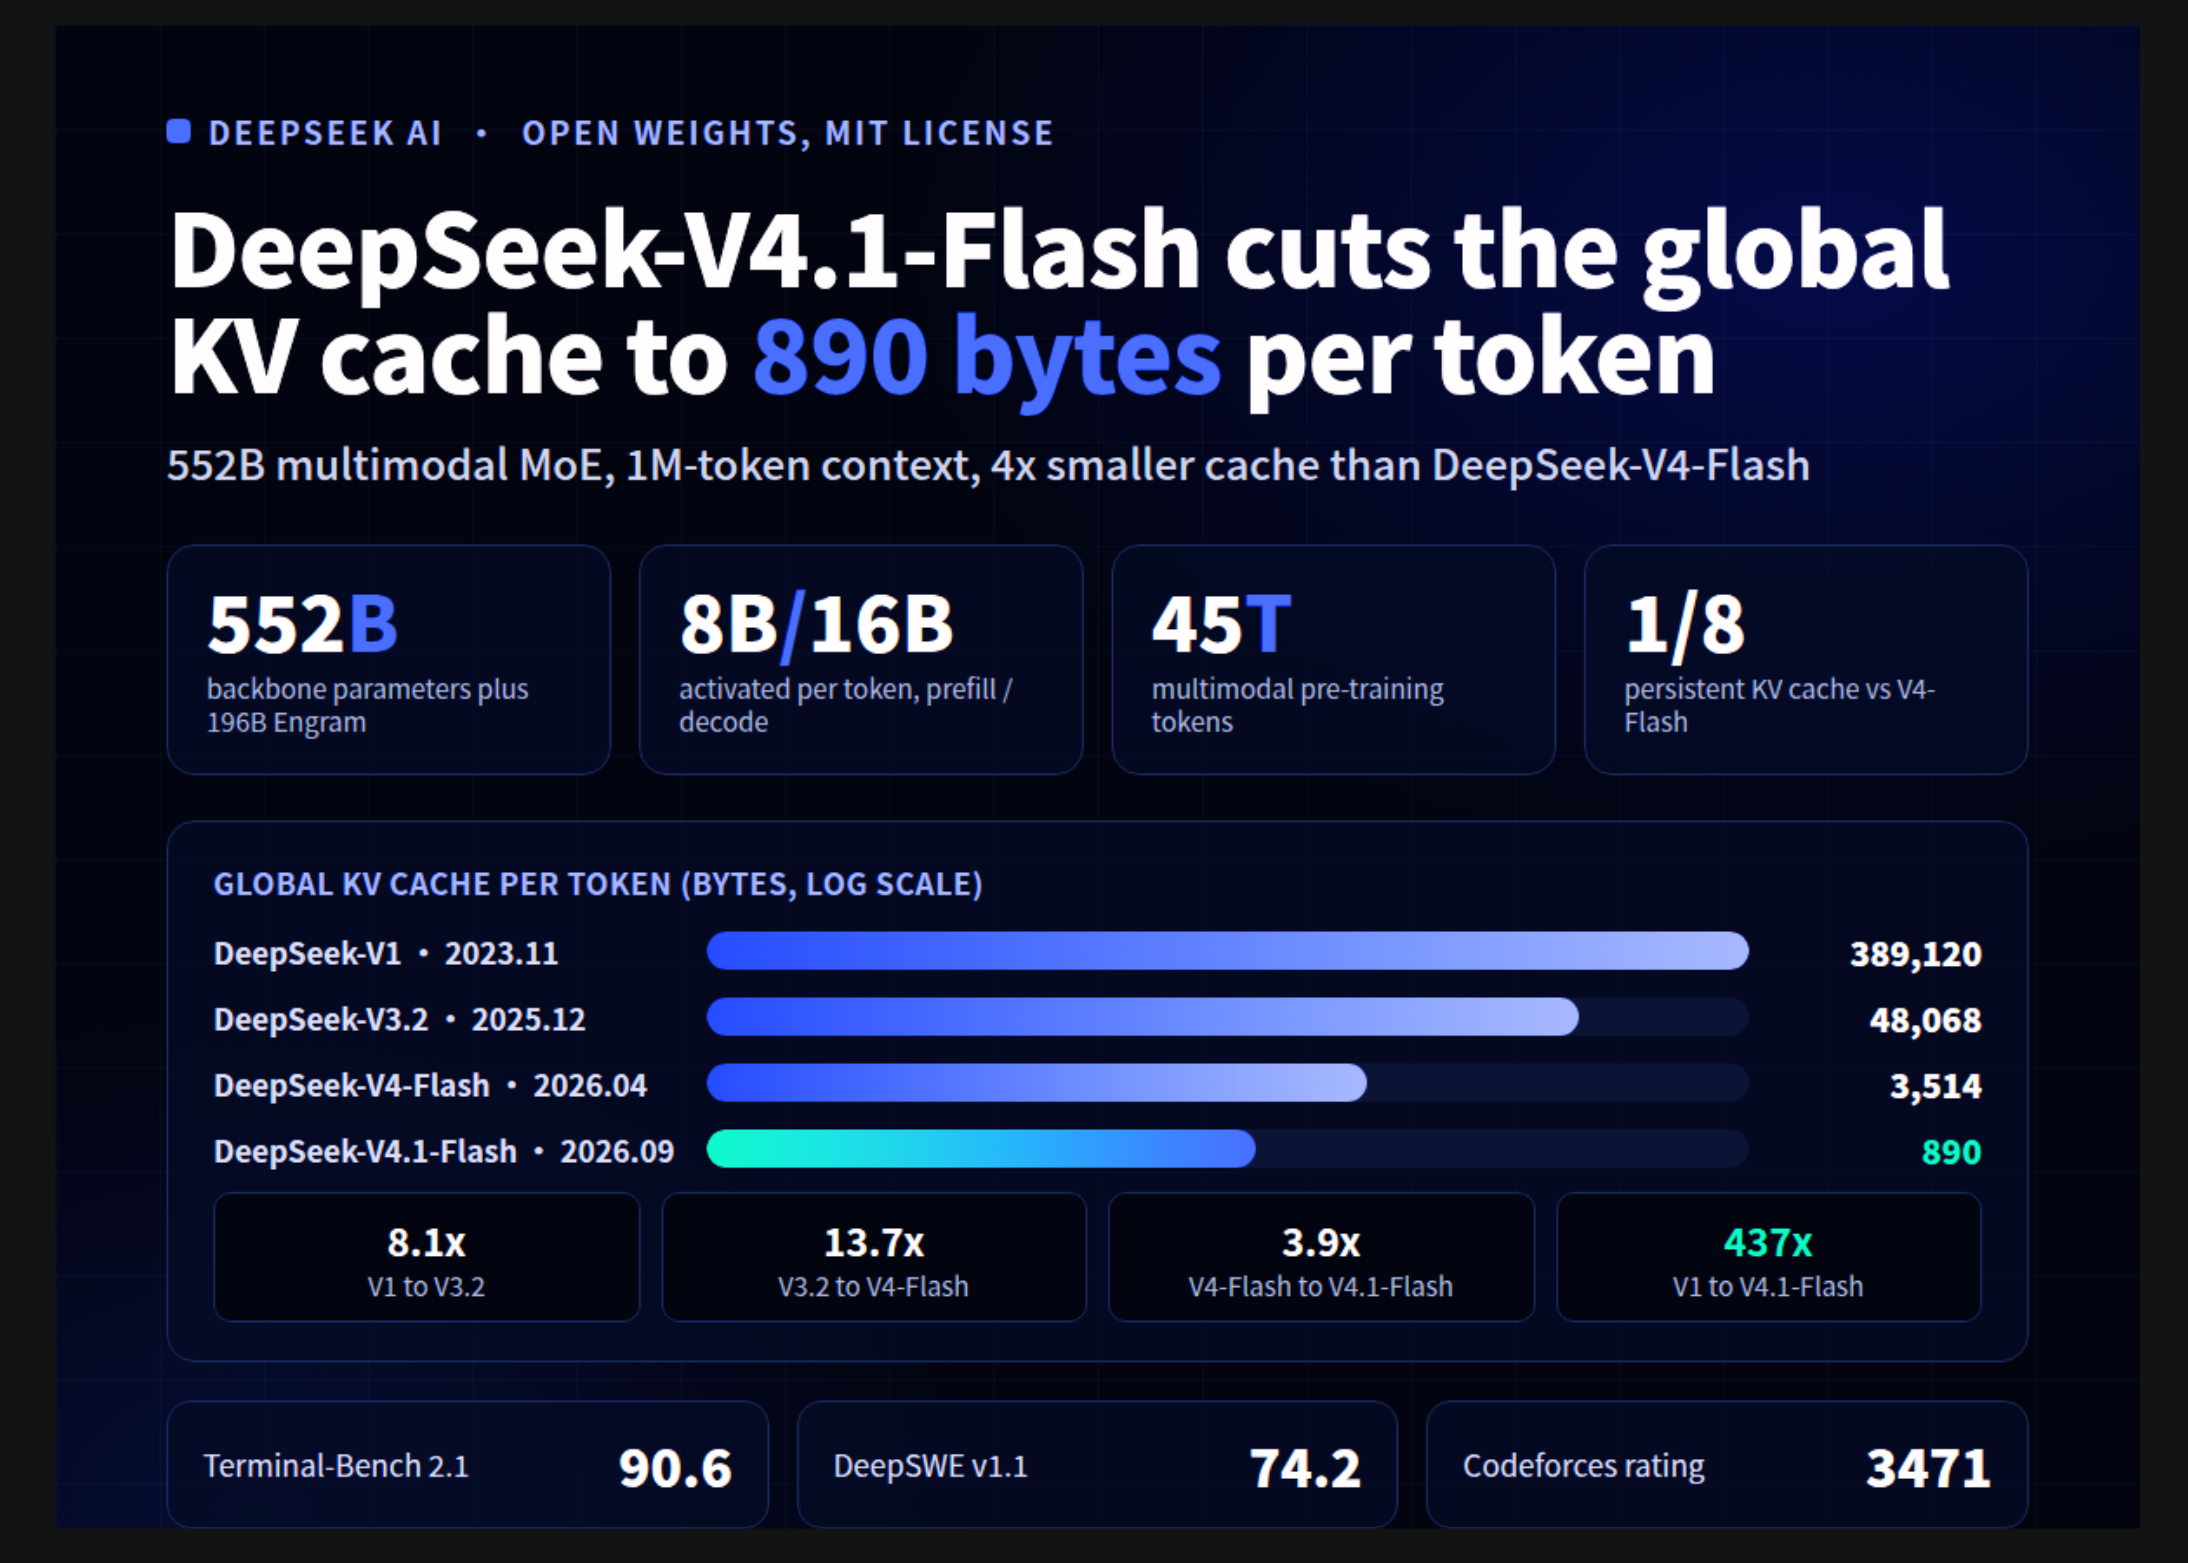
今日 AI 热点:DeepSeek AI Released DeepSeek-V4.1-Flash w

一句话结论:DeepSeek AI Released DeepSeek-V4.1-Flash with 1M Context, FP4 KV Cache, and Cross-Layer Attention Re。原始信息显示,这条动态来自 MarkTechPost,摘要线索为“Long-horizon agents have turned LLM serving into an input-heavy workload. Repeated prefills and million-token contexts leave KV caches that strain HBM, SSD capa”。它属于“Agent 与工作流”方向,可能影响工具选择、内容生产、开发工作流或企业落地判断。适合 AI 工具用户、运营/产品团队、开发者和正在做 AI 选型的中文用户阅读。下一步建议先核对原文,看它解决的具体任务、适用范围、价格或部署条件,再对照站内工具库、专题和知识图谱,判断是否值得收藏、试用或写成教程。

09 月 07 日 2026-09-07 快讯

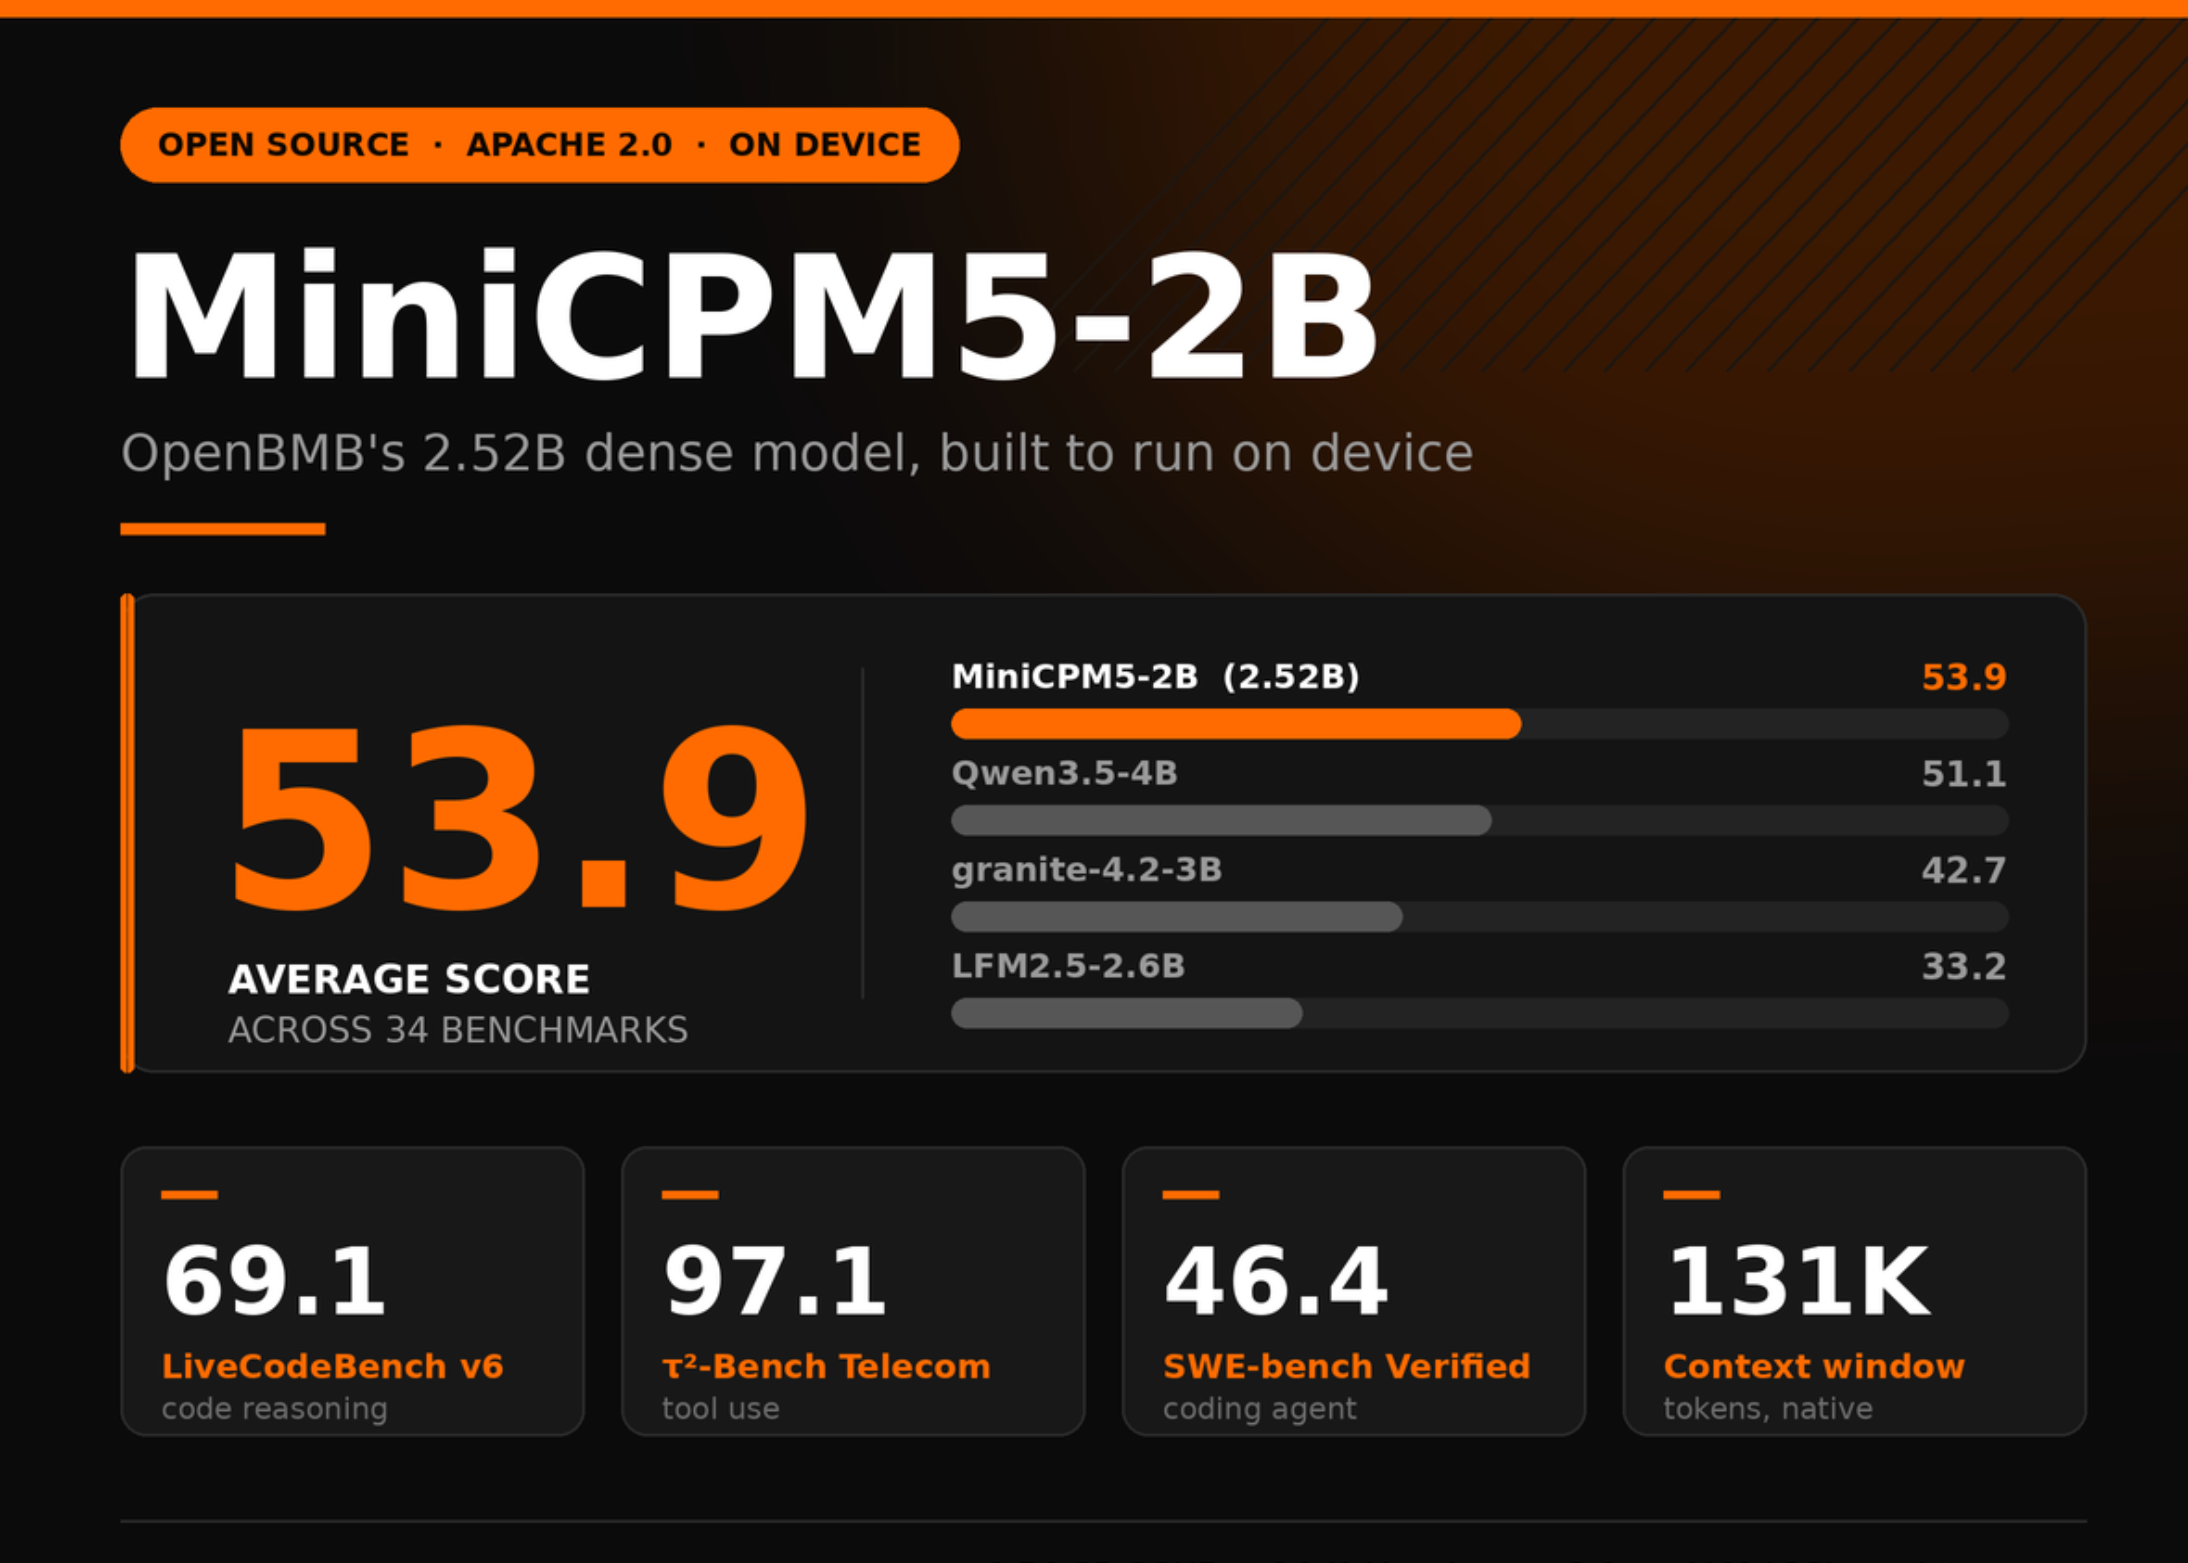
MiniCPM5-2B:25亿参数端侧模型平均分 53.9,超越 Qwen3.5-4B

一句话结论:OpenBMB 发布 MiniCPM5-2B,一个 25 亿参数的稠密模型,在 34 项基准测试中平均分达 53.9,超过 Qwen3.5-4B 的 51.1,且支持原生 13 万 token 上下文。原始信息显示,该模型拥有 2,516,756,480 参数,在工具调用、编程 Agent 和长上下文检索方面优势最明显,其训练过程结合了 4000 亿 token 的深度思考 SFT 和 RL 教师及在线蒸馏技术。值得关注是因为它证明了小参数模型也能在复杂任务上超越更大规模的模型,且专为端侧部署设计,意味着手机和物联网设备也能运行高性能 AI。影响人群包括移动端 AI 应用开发者、边缘计算工程师以及关注模型小型化技术的研究者。下一步验证方式:在 ModelScope 或 GitHub 上获取 MiniCPM5-2B 的权重,在本地设备或云服务器上部署,重点测试其在工具调用和长文档理解任务上的实际表现,并对比其推理速度和内存占用与 Qwen3.5-4B 的差异。

09 月 02 日 2026-09-02 快讯

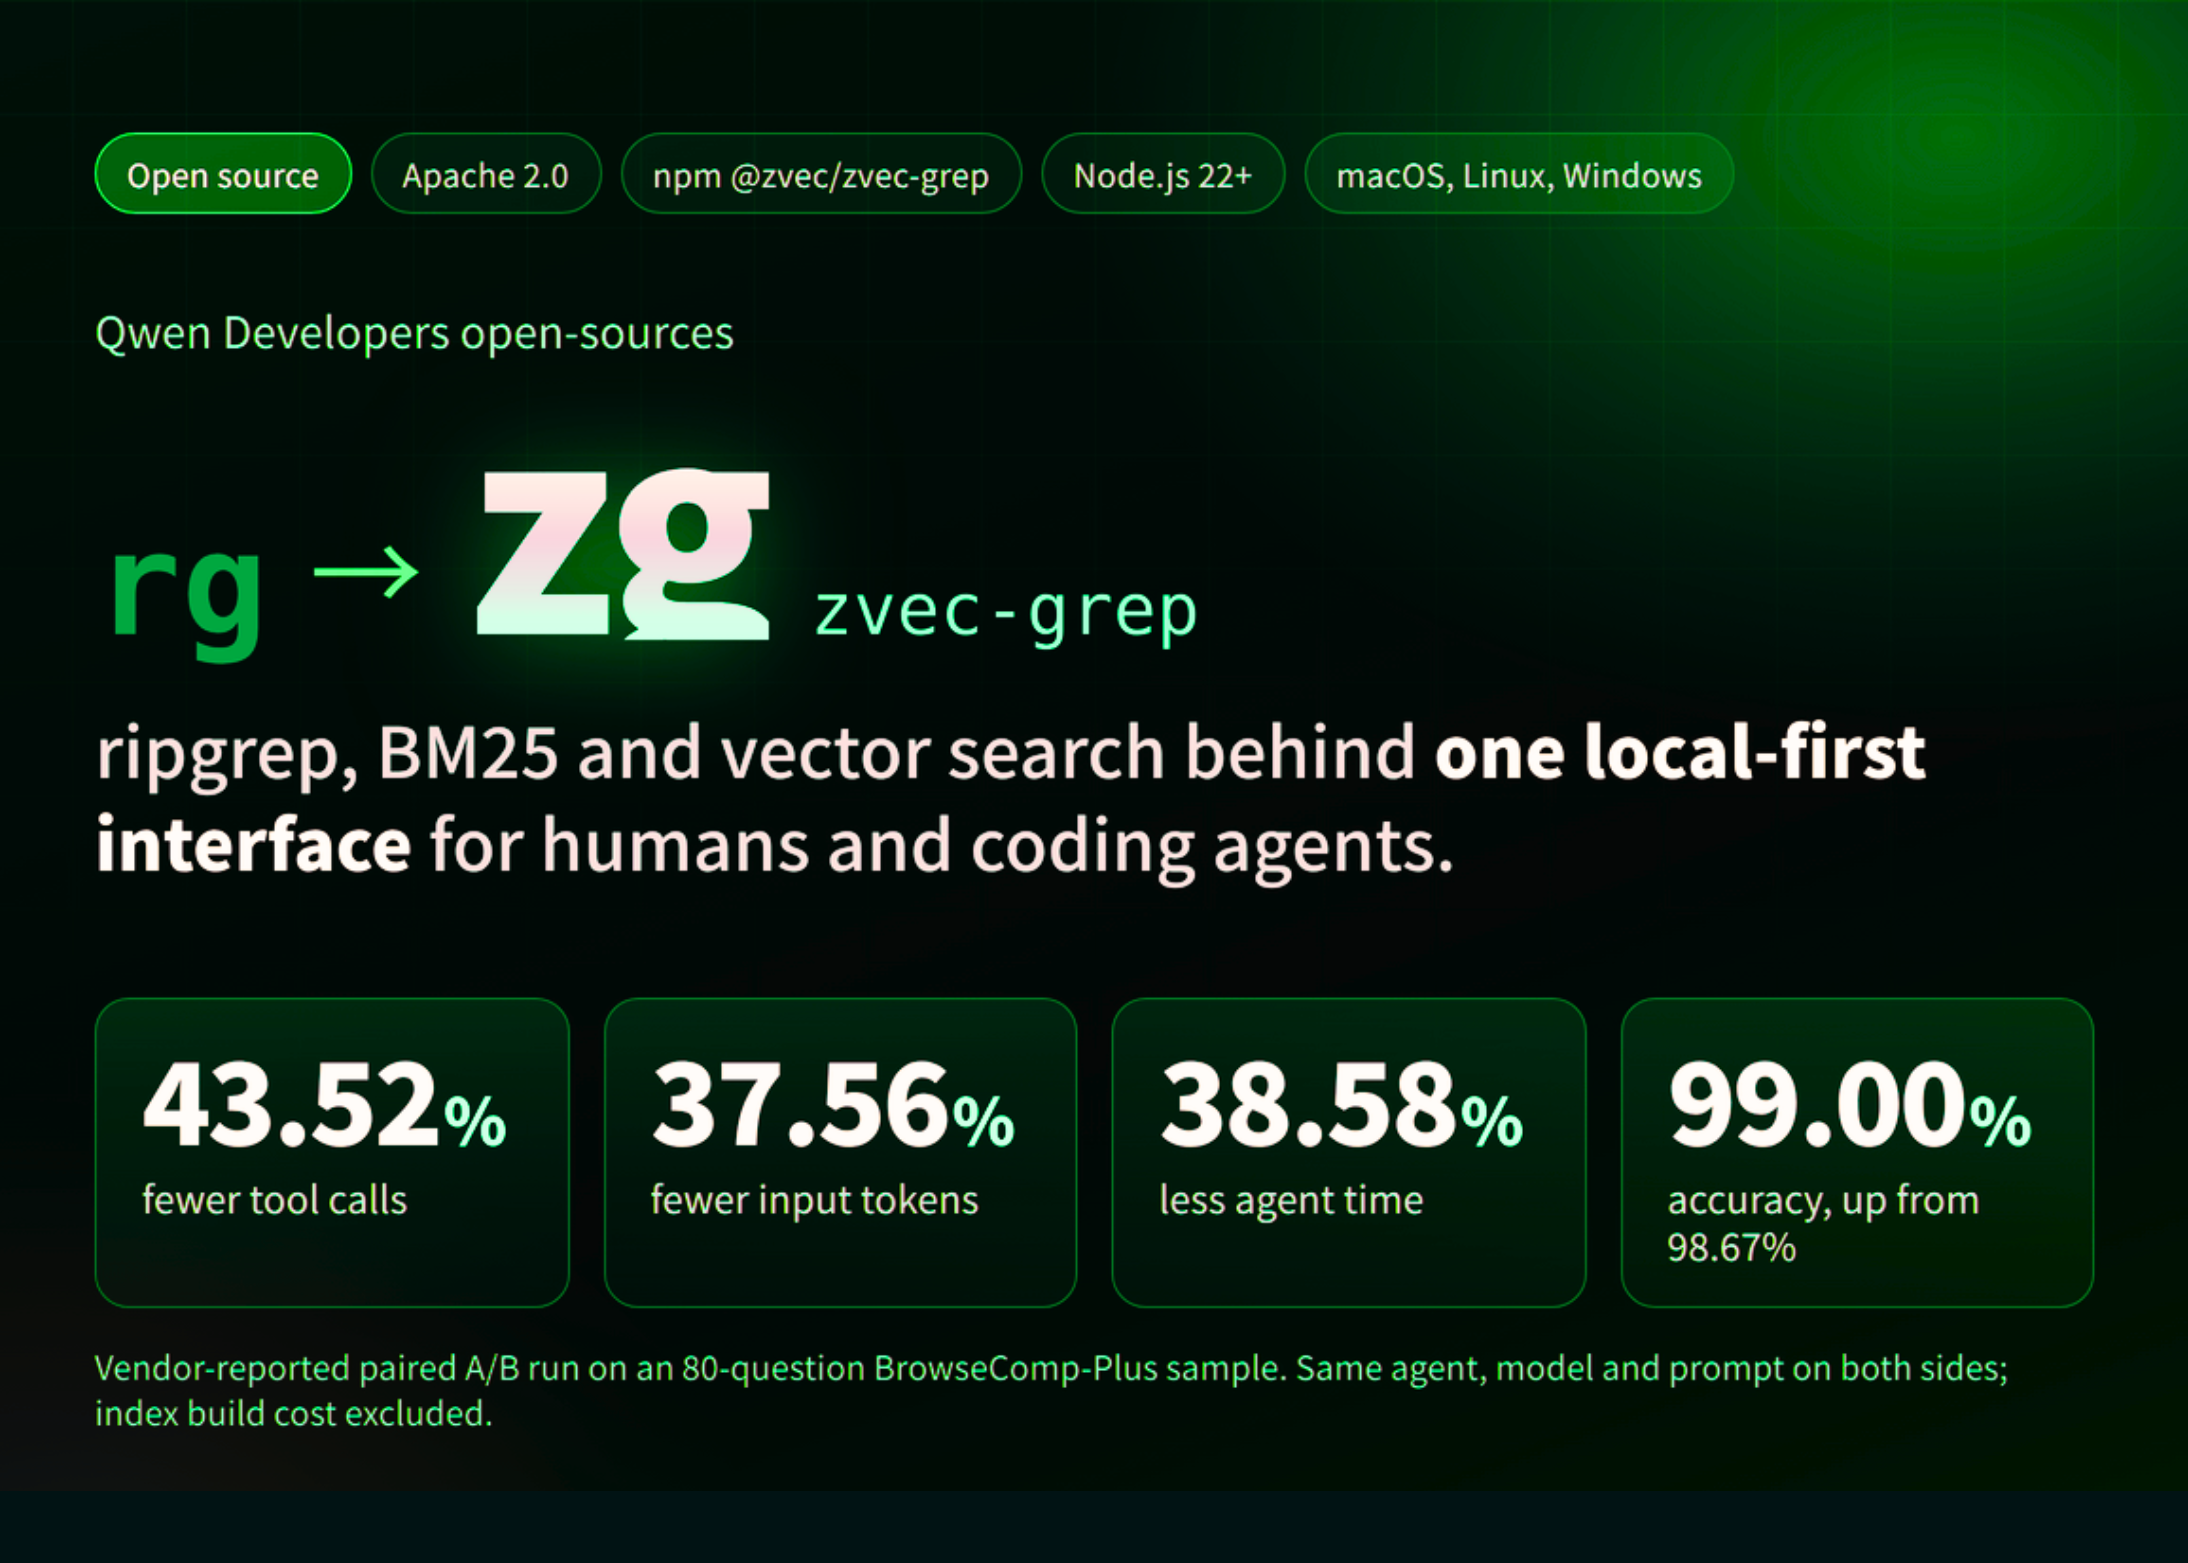
Qwen 开源 zg:一个本地优先的统一搜索层,融合 ripgrep、BM25 与向量检索

一句话结论:Qwen 开发者开源了 zg(zvec-grep),这是一个本地优先的搜索层,通过单一接口整合了 ripgrep、BM25 和向量搜索,让智能体无需切换工具即可从自然语言直达精确代码行。原始信息显示,该项目采用 Apache 2.0 许可,其设计亮点包括刻意保持小巧的 MCP 接口、设备端嵌入目录以及位于授权层之前的访问控制。值得关注的是,这解决了 AI 编程助手中常见的“工具切换”痛点,使得智能体能够在一个统一界面内完成从模糊描述到精确位置定位的检索任务,极大提升了代码检索效率。该工具主要影响使用 AI 编程助手进行大型代码库维护的开发者、DevOps 工程师以及构建本地知识库应用的团队。下一步建议直接克隆仓库并尝试在本地项目中安装,测试其能否通过自然语言查询快速定位到具体的代码行,并评估其索引速度与准确性是否优于现有的 grep 或 IDE 搜索。

08 月 30 日 2026-08-30 快讯

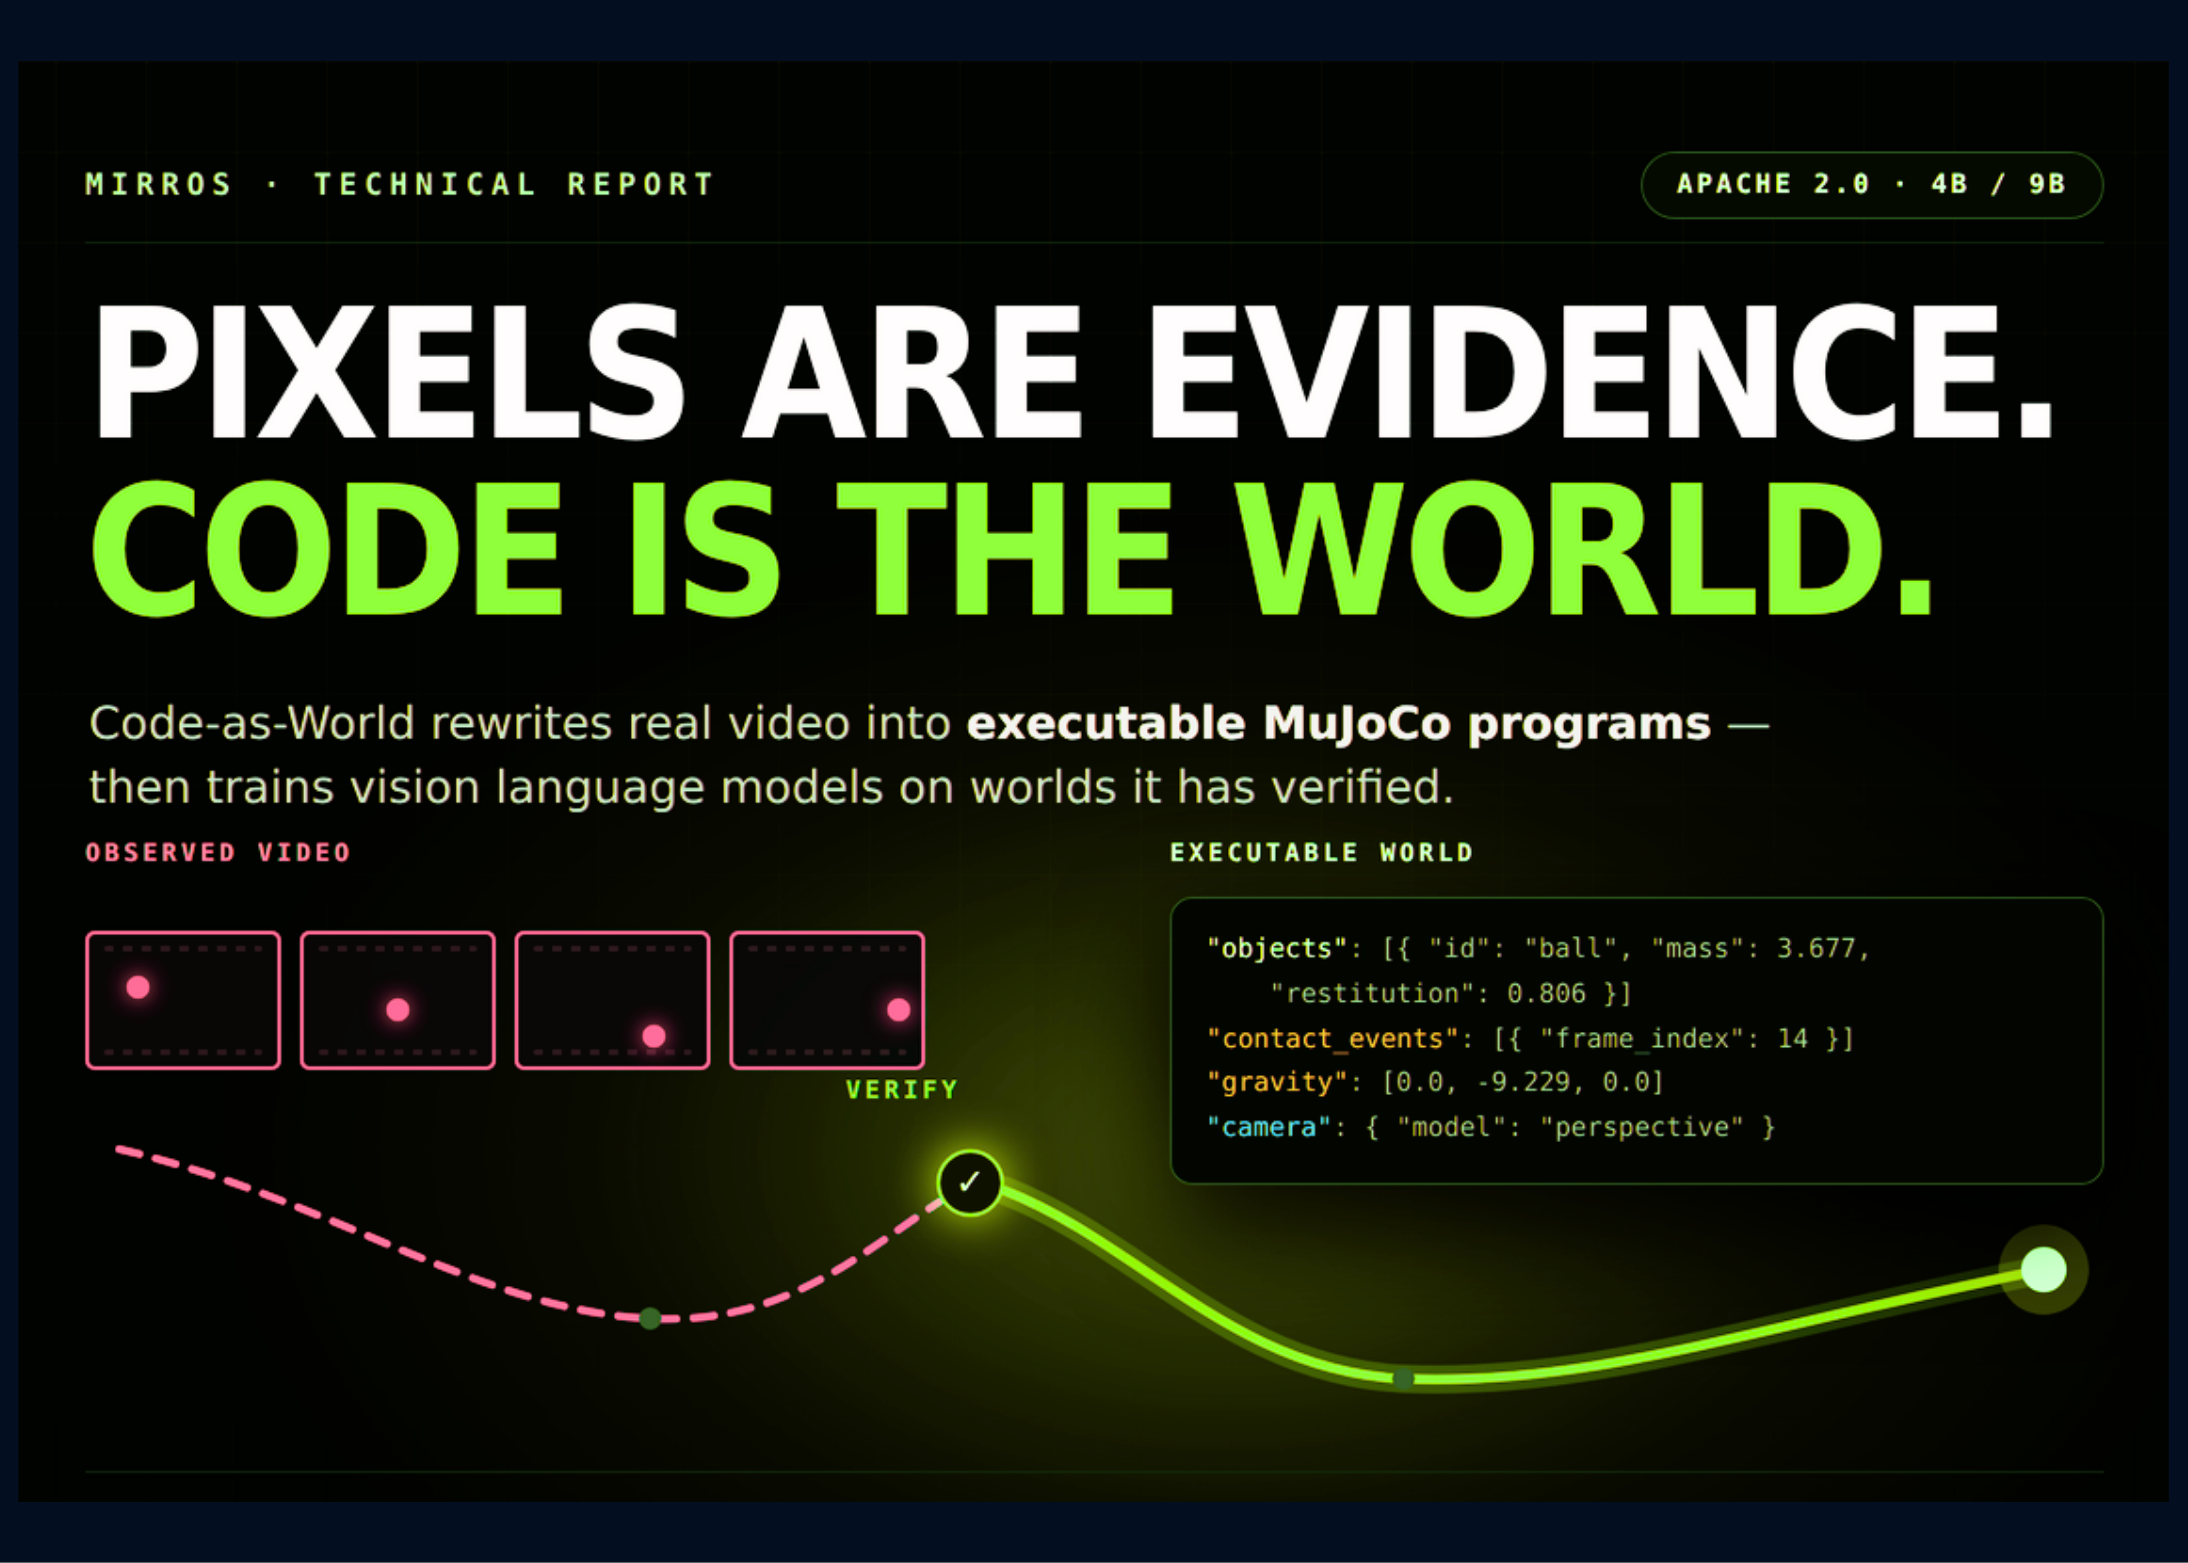
Code-as-World:将真实视频重写为可执行 MuJoCo 物理程序的 Agent 循环

一句话结论:Code-as-World 是一种 Agent 循环,能从真实视频中恢复可编辑的 MuJoCo 场景代码,并利用这些验证过的世界来训练物理推理能力。原始信息来自 MarkTechPost 的论文介绍,该方法将视频内容转化为可执行的物理程序,从而为模型提供结构化的训练环境。值得关注的原因是它突破了传统视频理解仅做识别的局限,实现了从感知到可交互物理世界的跨越,对机器人学习和物理推理研究有重要意义。影响人群包括计算机视觉研究者、机器人领域工程师,以及关注具身智能的 AI 从业者。下一步建议阅读原论文了解技术细节,并关注其代码是否开源,若可用则尝试在标准视频数据集上复现实验,以验证效果。

08 月 11 日 2026-08-11 快讯

用 ComfyUI API 构建 MiniMax-H3 多模态视频与音频生成流水线

一句话结论:本文展示了如何利用 ComfyUI 作为无头后端,构建一个可编程的 MiniMax-H3 多模态生成流水线,实现视频与音频的联合生成。原始信息详细描述了从硬件配置、模型权重下载、动态图构建到音视频联合解码的完整自动化推理环境搭建过程。值得关注的原因在于,它提供了一种将前沿多模态模型集成到现有工作流中的工程化方法,降低了开发者直接操作底层模型的门槛。该指南主要影响 AIGC 应用开发者、视频内容创作者以及研究多模态生成的算法工程师。下一步建议按照文章步骤在本地或云端环境复现该流水线,测试不同提示词下的视频与音频生成质量,并评估其推理速度与资源消耗,以判断是否适合集成到自己的创作工具或产品中。

08 月 07 日 2026-08-07 快讯

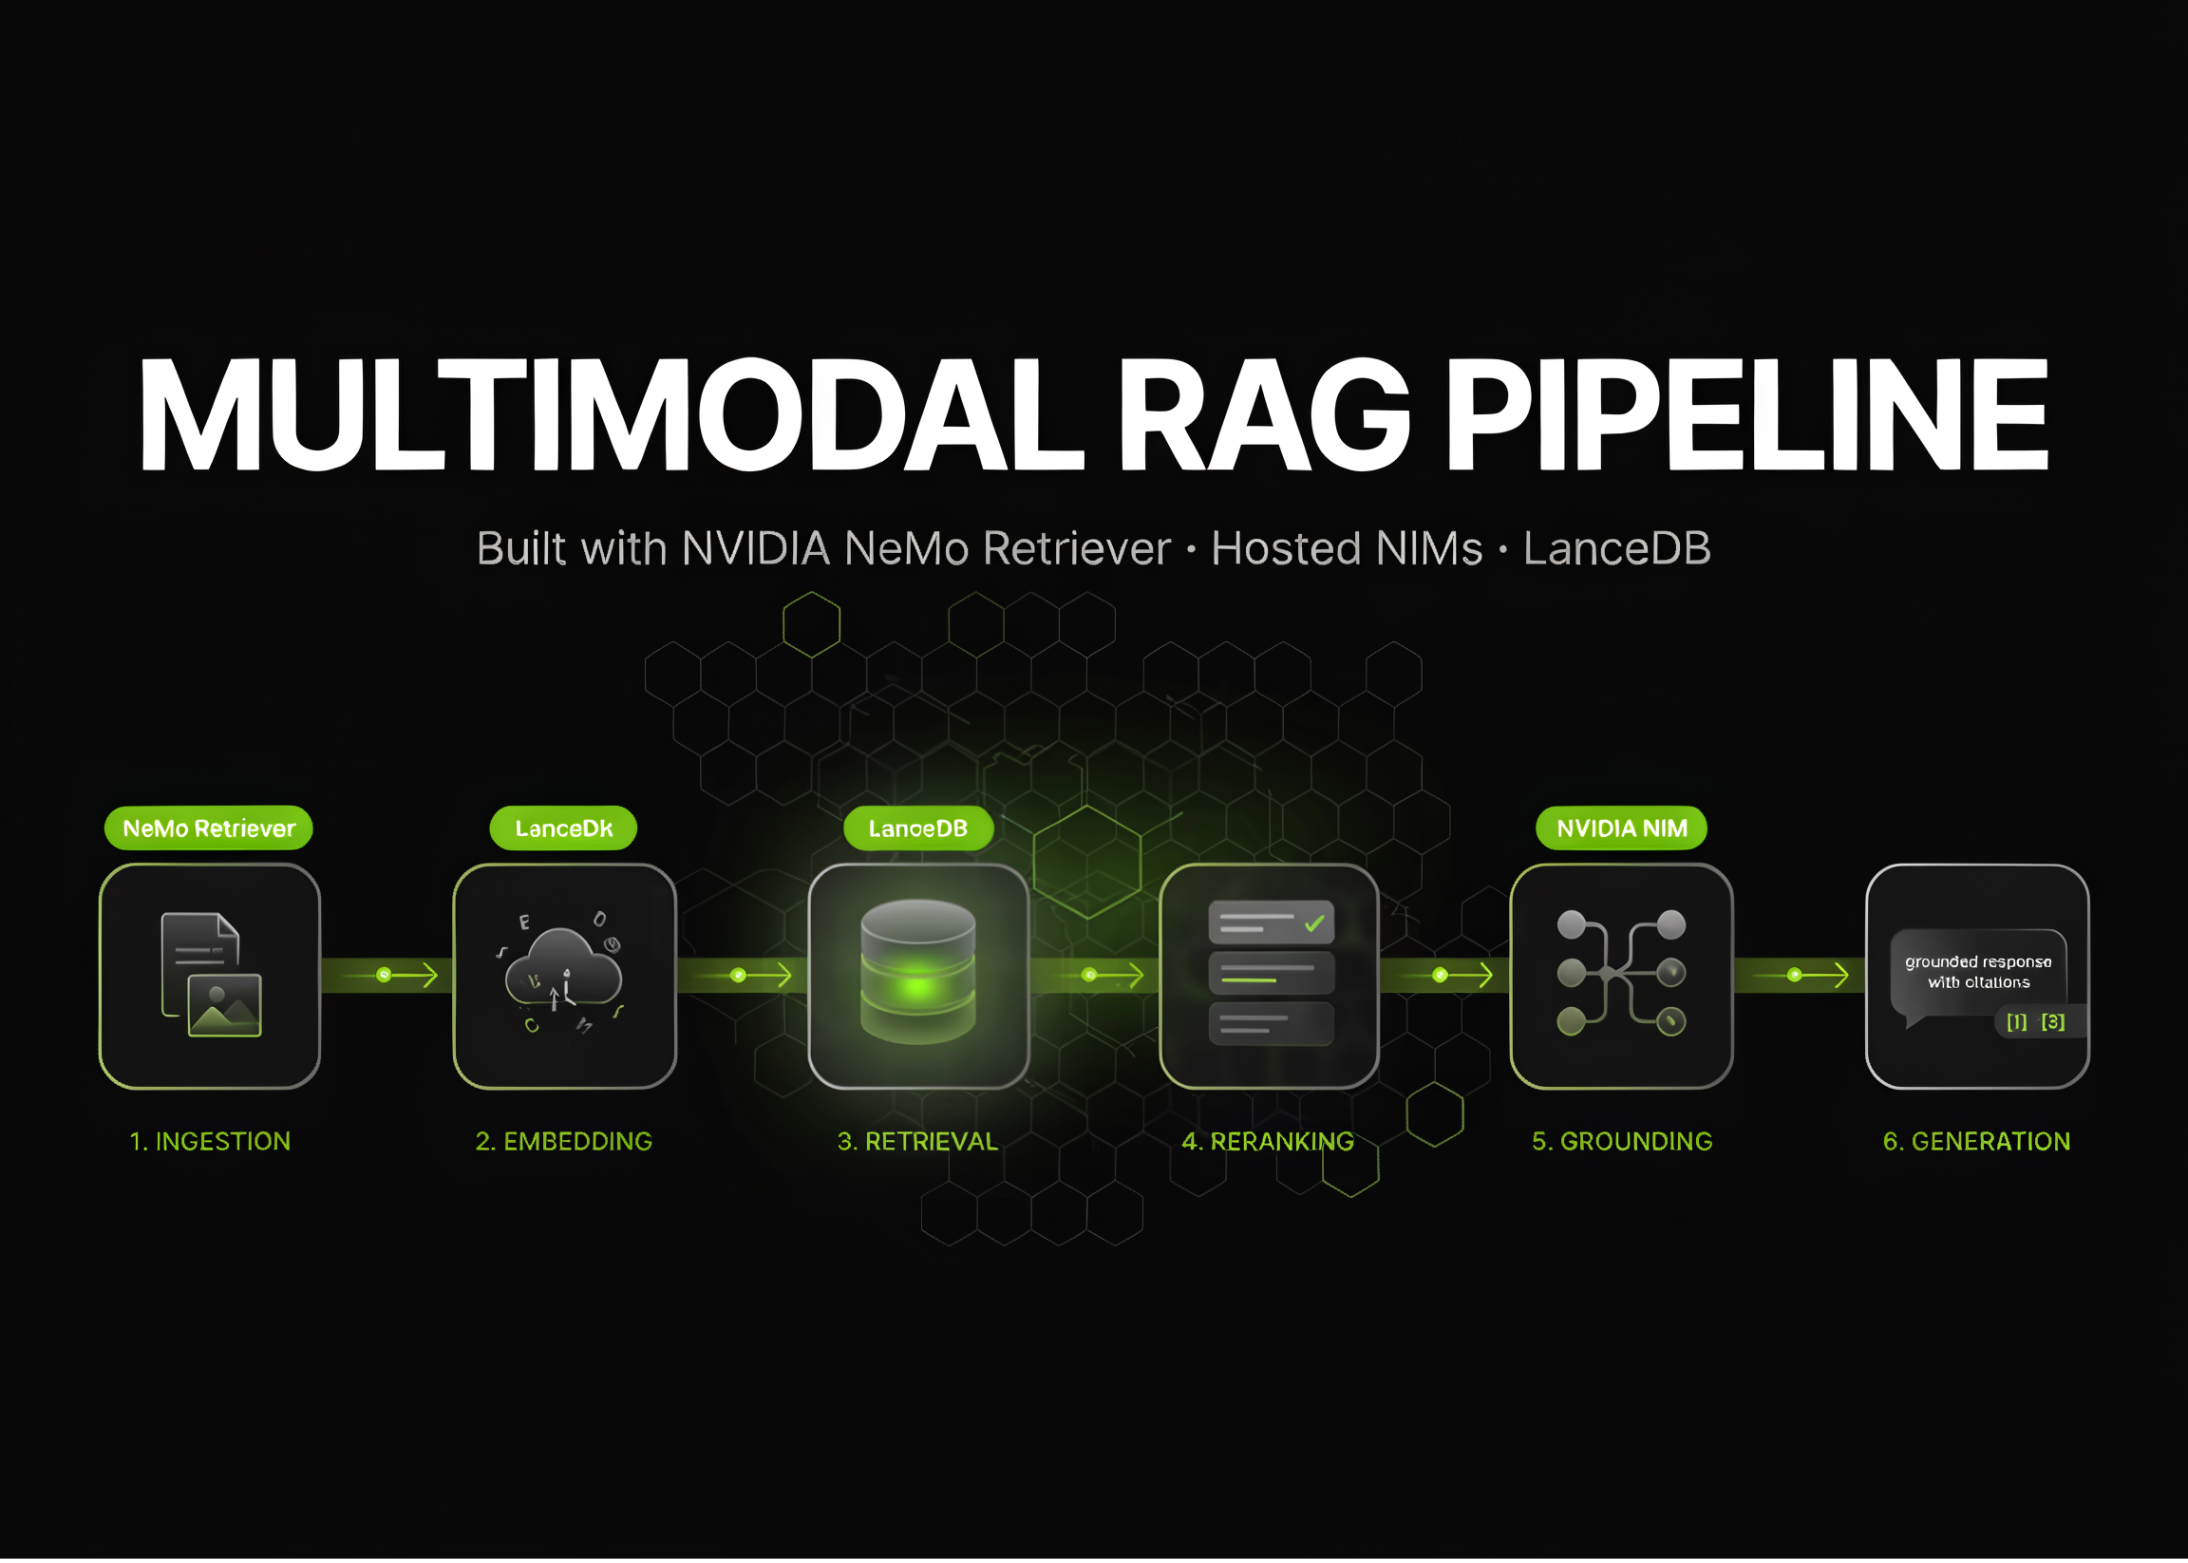
教程:使用 NVIDIA NeMo Retriever 构建多模态 RAG 流水线

一句话结论:该教程展示了如何用 NVIDIA NeMo Retriever 构建多模态 RAG 流水线,涵盖 PDF 文本提取、NIM 端点、重排序和生成。原始信息来自 MarkTechPost 的教程文章,其内容提到配置 Python 3.12 环境、离线 PDF 文本提取,并扩展至 NVIDIA NIM 端点以检测页面。这值得关注,因为它提供了一套完整的、可操作的多模态 RAG 实现路径,且部分步骤无需 GPU 或 API 密钥。影响人群主要是机器学习工程师、RAG 应用开发者。下一步建议阅读原文,按照步骤搭建环境,并重点测试离线提取与 NIM 端点结合的效果。

08 月 06 日 2026-08-06 快讯

微软 SkillOpt:Agent 技能跨模型与跨框架迁移,Codex 技能提升 Claude Code 成绩近 60 分

一句话结论:微软 SkillOpt 证明优化后的 Agent 技能可跨模型和跨框架迁移,Codex 训练的 SpreadsheetBench 技能让 Claude Code 得分从 22.1 跃升至 81.8。原始信息强调,该研究最关键的发现并非 52/52 的满分成绩,而是技能工件在不同环境中的泛化能力,但迁移效果因任务类型差异显著,表格类任务保留率达 102%,数学类任务仅 10%。值得关注的原因是,这意味着 Agent 技能可以像软件包一样被训练一次、多处部署,极大降低重复训练成本,但任务类型对迁移效果的影响仍需深入研究。影响对象是研究 Agent 泛化能力的学者、构建多框架 Agent 系统的工程师,以及依赖 Claude Code 或 Codex 的自动化团队。下一步建议阅读论文第 4.3 节,并尝试将已训练的技能工件导入不同 Agent 框架,验证其在实际业务任务中的迁移表现。

08 月 03 日 2026-08-03 快讯

阿里 Qwen3.8-Max 正式发布:2.4T 参数 MoE 模型开放商用

一句话结论:阿里通义千问团队将 Qwen3.8-Max 从预览转为正式商用,并公布了按 token 计费的价格,开源权重预计下周发布。原始信息显示,这是一个拥有 2.4 万亿参数的混合专家(MoE)模型,支持文本、图像和视频输入,上下文窗口长达 100 万 token,但官方尚未公布基准测试数据。它值得关注是因为这是 Qwen 家族迄今最强的模型,其正式商用和即将开源意味着开发者可以合法、低成本地使用顶级模型能力,可能对开源社区和商业应用产生深远影响。该模型主要影响大模型应用开发者、AI 研究机构以及需要处理长文档或多模态内容的企业。下一步,你可以关注 Qwen 官方仓库获取开源权重,或通过阿里云百炼平台申请 API 试用,验证其在你的任务上的实际表现。

08 月 02 日 2026-08-02 快讯

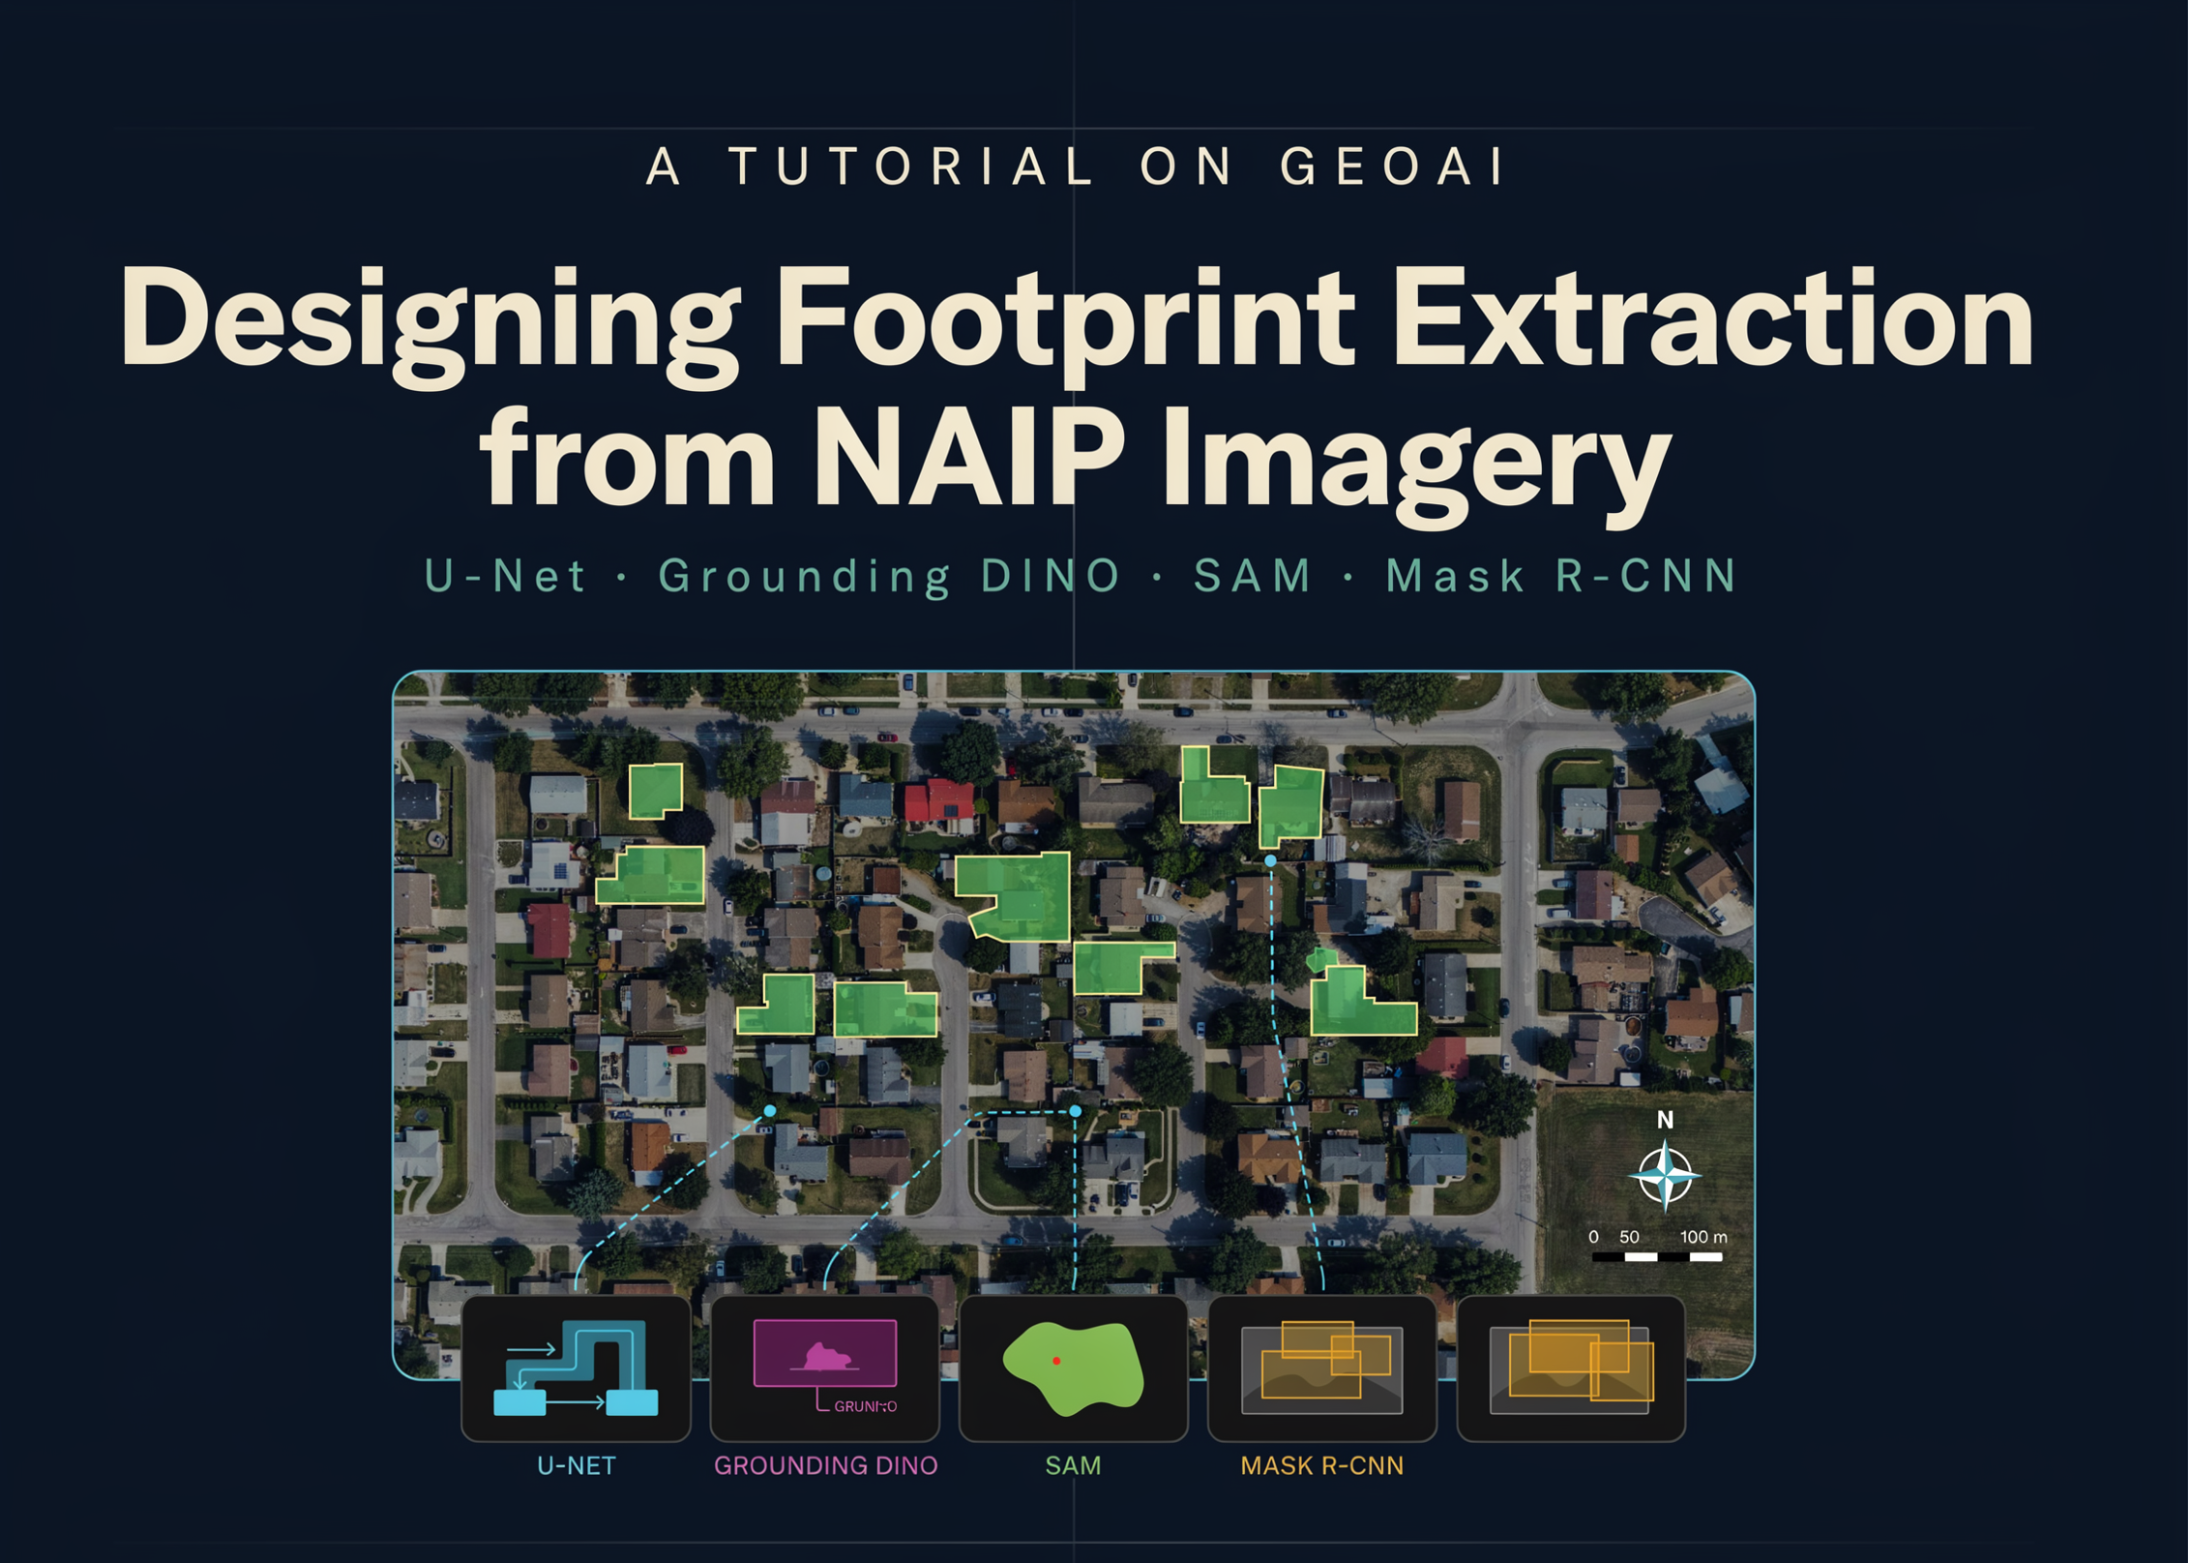
GeoAI 实战教程:融合 U-Net、DINO 与 SAM 提取建筑足迹

一句话结论:一篇完整教程展示了如何结合 U-Net、Grounding DINO、SAM 和 Mask R-CNN 从 NAIP 航拍影像中提取建筑足迹。原始信息详述了从配置地理空间深度学习环境、下载影像与矢量标签、生成地理参考图像块,到训练 ResNet-34 主干 U-Net 模型的完整流程。这值得关注,因为它提供了一个可复现的 GeoAI 工作流范本,将基础分割模型与先进视觉模型结合,解决了高分辨率遥感影像分析的实操难题。影响的是地理信息科学、遥感、城市规划等领域的研究人员和工程师。下一步建议按照教程步骤,在本地或云端环境复现该流程,并尝试替换不同的基础模型或调整训练参数,以评估各环节对最终提取精度的影响。

07 月 28 日 2026-07-28 快讯

Kimi CLI 非交互式编码工作流:JSONL 流式、测试与会话记忆

一句话结论:本教程展示了如何将 Kimi CLI 配置为完全非交互式 AI 编码 Agent,支持 JSONL 流式输出、测试和会话记忆。原始信息详细介绍了通过 uv 安装、配置 Moonshot API 以及构建 Python 封装器的过程。这意味着开发者可以在自动化流水线中集成 Kimi CLI,实现无人值守的代码生成和测试。值得关注的原因是,它展示了非交互式 Agent 工作流的实际应用,尤其适合 CI/CD 和批量任务。受影响最大的是使用 Moonshot API 的开发者、自动化工程师以及需要代码生成流水线的团队。下一步建议按照教程配置 Kimi CLI,并尝试在非交互模式下执行一个简单的编码任务。

07 月 26 日 2026-07-26 快讯

今日 AI 热点:Induction Labs Photon-1 Simulates Desktops

一句话结论:Induction Labs Photon-1 Simulates Desktops, Plays Checkers, and Models Billiard Physics From One Pre。原始信息显示,这条动态来自 MarkTechPost,摘要线索为“Most agents that learn from video need to know what action produced each frame. Induction Labs is arguing that this requirement is the bottleneck. Last week, th”。它属于“Agent 与工作流”方向,可能影响工具选择、内容生产、开发工作流或企业落地判断。适合 AI 工具用户、运营/产品团队、开发者和正在做 AI 选型的中文用户阅读。下一步建议先核对原文,看它解决的具体任务、适用范围、价格或部署条件,再对照站内工具库、专题和知识图谱,判断是否值得收藏、试用或写成教程。

07 月 24 日 2026-07-24 快讯

构建端到端 OCR 流水线:使用百度 Unlimited-OCR 处理高分辨率图像与多页 PDF

一句话结论:本教程展示了如何使用百度 Unlimited-OCR 模型构建端到端 OCR 流水线,处理高分辨率图像和多页 PDF。原始信息详细介绍了从 GPU 环境配置到高细节平铺推理与快速基础模式对比的完整流程。这值得关注,因为 OCR 是文档数字化和自动化处理的关键技术,而 Unlimited-OCR 在处理密集布局、表格和跨页内容方面表现出色。影响对象包括文档处理工程师、数据录入团队,以及需要从扫描件或 PDF 中提取结构化信息的组织。下一步建议按照教程步骤,在 GPU 环境下部署 Unlimited-OCR 模型,并用实际的高分辨率文档或多页 PDF 测试其识别准确率和速度。

07 月 20 日 2026-07-20 快讯

阿里通义实验室发布 Qwen-Audio-3.0-TTS 语音合成模型

一句话结论:阿里通义实验室发布 Qwen-Audio-3.0-TTS,提供 Flash 和 Plus 两种版本,支持 16 种语言。原始信息明确发生了什么:Flash 版本面向实时交互,Plus 版本面向高质量生成,均通过阿里云模型工作室托管,不提供下载权重。为什么值得关注:该模型专注于生产环境,解决延迟和音质问题,适合语音助手和内容生成。影响谁:语音应用开发者、客服系统和多媒体创作者。下一步怎么验证或使用:可通过阿里云 API 调用测试,对比 Flash 和 Plus 在实时性和质量上的表现。

07 月 19 日 2026-07-19 快讯

阿里预览 Qwen3.8-Max:2.4 万亿参数多模态 MoE 模型

一句话结论:阿里预览了 Qwen3.8-Max-Preview,一个 2.4 万亿参数的多模态 MoE 模型,但缺乏基准数据和定价细节。原始信息明确发生了什么:阿里 Qwen 团队预览了 Qwen3.8-Max-Preview,声称其性能仅次于 Fable 5,并在 Token Plan、Qoder 和 QoderWork 上以标准定价的 10% 提供预览。但未公布基准测试表、模型卡、许可证、每 token 价格或激活参数数量。为什么值得关注:2.4 万亿参数规模使其成为目前最大的开源级多模态模型之一,但缺乏透明数据让社区难以验证其真实性能。影响谁:主要影响大模型研究者、AI 应用开发者和关注模型能力对比的技术决策者。下一步怎么验证或使用:在 Token Plan 等平台试用 Qwen3.8-Max-Preview,自行构建测试集评估其在多模态理解、推理和生成任务上的表现,并与 Qwen2.5 系列进行对比。

在 Google Colab 单 GPU 上使用 NeMo AutoModel 微调 Qwen3 的完整教程

一句话结论:一篇教程详细展示了如何在 Google Colab 的单 GPU 环境下,使用 NVIDIA NeMo AutoModel 对 Qwen3-0.6B 模型进行 LoRA 微调。原始信息来自 MarkTechPost,教程从验证 CUDA 硬件开始,安装 NeMo AutoModel,加载官方 LoRA 配置,调整精度、批大小、检查点和调度器设置,最终通过 CLI 启动微调并对比基座模型效果。这一教程值得关注,因为它为资源有限的开发者和研究者提供了在免费 Colab 环境中微调最新 Qwen3 模型的完整可复现流程,降低了 LoRA 微调的门槛。主要影响大模型微调研究者、AI 应用开发者以及希望在低成本环境下实验模型定制化的团队。下一步可以按照教程步骤在 Google Colab 中逐行运行代码,尝试微调自己的数据集,并观察 LoRA 微调后的模型在特定任务上的性能变化。

07 月 14 日 2026-07-14 快讯

Anthropic Claude Sonnet 5 在智能体编程基准测试中接近 Opus 4.8

Anthropic 发布了 Claude Sonnet 5,其在智能体编程基准测试中的表现接近 Opus 4.8,但价格仍保持在 Sonnet 系列的低价位。这一对比分析表明,Sonnet 5 在性价比上具有显著优势,尤其适合对成本敏感的智能体编程任务。对于开发者和企业来说,这意味着可以在不牺牲太多性能的情况下,大幅降低使用 Claude 进行编程任务的成本。建议开发者查阅 MarkTechPost 的详细对比文章,了解具体的基准测试结果和定价差异,并根据自己的任务需求选择合适的模型。

07 月 13 日 2026-07-13 快讯

教程:构建 VideoAgent 风格的多智能体系统,实现视频编辑任务

一句话结论:本教程展示了如何构建一个无需 API Key 的多智能体视频编辑系统,包含意图解析、图规划、工具路由和文本梯度优化等组件。原始信息明确发生了什么:MarkTechPost 发布教程,详细介绍了如何重建 VideoAgent 工作流,构建一个可运行的多智能体管道。该系统包括意图解析器、代理库、工具路由器、图规划器以及文本梯度优化器,并集成了 FFmpeg、Whisper 转录、场景检测、关键帧采样、字幕生成、跨模态索引和节拍同步编辑等功能。为什么值得关注:该教程提供了一个完整的、可复现的多智能体视频编辑框架,展示了如何将规划、优化与多种媒体处理工具结合,对 AI 视频编辑研究和应用有重要参考价值。影响谁:主要影响 AI 研究人员、视频编辑工具开发者以及对多智能体系统感兴趣的工程师。下一步怎么验证或使用:读者可以按照教程步骤,在本地搭建该多智能体系统,并使用自己的视频素材测试其意图解析和编辑效果。

07 月 10 日 2026-07-10 快讯

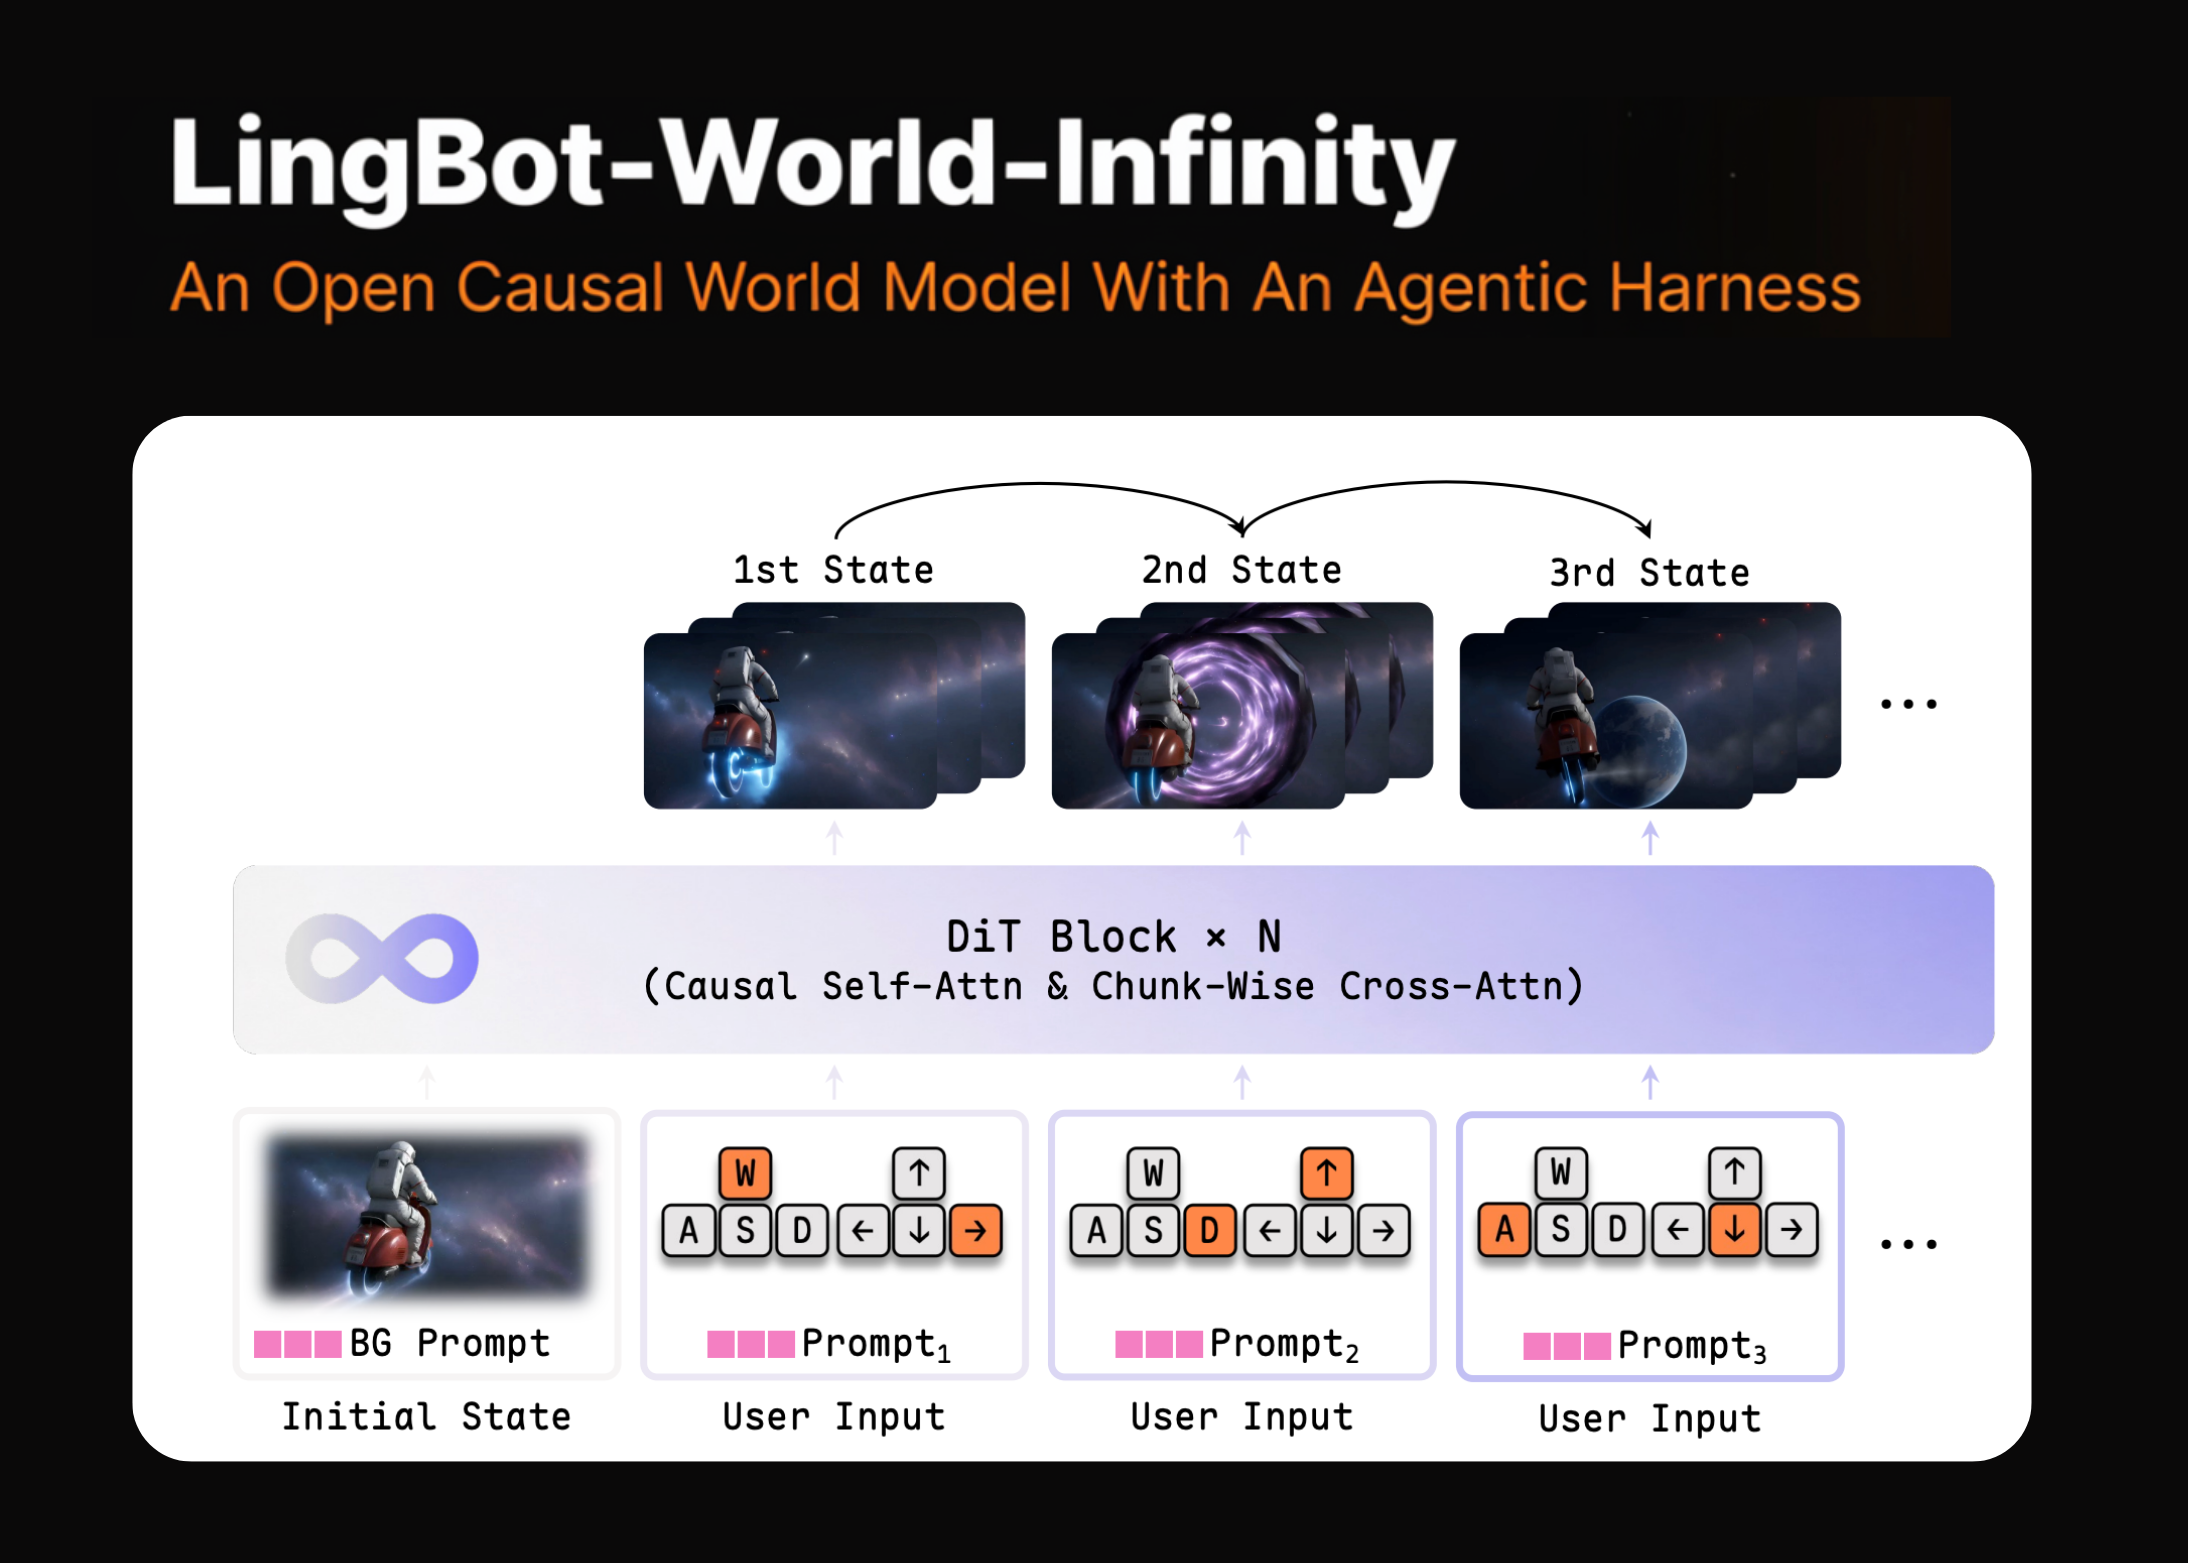
LingBot-World-Infinity:蚂蚁集团开源 14B 因果世界模型,支持交互式视频模拟

一句话结论:蚂蚁集团机器人团队发布了 LingBot-World-Infinity,一个 14B 参数的因果视频生成模型,可作为交互式世界模拟器使用。原始信息明确发生了什么:Robbyant(蚂蚁集团具身智能部门)发布了 LingBot-World-Infinity(LingBot-World 2.0),这是一个 14B 参数的因果视频生成模型,核心创新是混合双向和自回归注意力掩码(MoBA),并结合分布匹配蒸馏技术,旨在解决长程自推演中的漂移问题。为什么值得关注:该模型作为开源因果世界模型,为具身智能和视频模拟领域提供了强大的基础工具,MoBA 注意力机制可能成为未来视频生成的重要方向。影响谁:主要影响具身智能研究者、视频生成开发者以及需要交互式模拟环境的游戏和机器人领域。下一步怎么验证或使用:研究者可从 GitHub 或 ModelScope 获取模型权重,按照文档配置环境,尝试输入初始帧或指令进行视频生成和交互式模拟测试。

07 月 09 日 2026-07-09 快讯

Meta 发布 Muse Spark 1.1:面向 Agent 任务的多模态推理模型

一句话结论:Meta Superintelligence Labs 发布了 Muse Spark 1.1,一个面向 Agent 任务的多模态推理模型,拥有百万 token 上下文窗口。原始信息明确发生了什么:Meta 于 2026 年 7 月 9 日发布了 Muse Spark 1.1,同时公开预览了 Meta Model API。该模型专为 Agent 任务设计,具有 100 万 token 的上下文窗口并主动压缩,支持零样本泛化到新工具和 MCP 服务器,以及跨并行子 Agent 的多 Agent 委派。Meta 的发布表格显示其在工具使用上领先,但在其他方面稍逊。为什么值得关注:该模型代表了 Meta 在 Agent 领域的最新进展,其百万 token 上下文和零样本工具泛化能力可能改变 Agent 系统的构建方式。影响谁:AI 研究人员、Agent 系统开发者、使用 Meta 模型的开发者,以及关注多模态推理模型进展的从业者。下一步怎么验证或使用:开发者可申请 Meta Model API 预览,测试 Muse Spark 1.1 在工具使用和多 Agent 委派任务上的表现,对比其与 GPT-4 等模型的差异。

07 月 07 日 2026-07-07 快讯

OpenAI 发布 GPT-Realtime-2.1 系列,降低语音 Agent 延迟

一句话结论:OpenAI 发布 GPT-Realtime-2.1 和 GPT-Realtime-2.1-mini,用于低延迟语音 Agent,并降低 p95 延迟至少 25%。原始信息显示,OpenAI 在 API 中新增了两个 Realtime 模型,其中 mini 版本为语音推理模型,定价与之前版本一致,同时通过改进缓存显著降低了延迟。这个更新值得关注,因为它直接提升了语音交互的实时性,对语音助手、客服机器人等应用至关重要。影响对象包括语音应用开发者、对话式 AI 产品团队以及使用 OpenAI API 的企业。下一步,开发者可以尝试在 API 中调用新模型,对比延迟和成本,并探索其在 WebRTC 场景下的应用。

07 月 02 日 2026-07-02 快讯

RAG-Anything 教程:在 Colab 中构建多模态检索管道

一篇教程详细介绍了如何使用 RAG-Anything 在 Google Colab 中构建支持文本、表格、公式和图片的多模态检索管道。教程引导用户准备环境、输入 OpenAI API 密钥,并生成包含图表和 PDF 的合成报告,然后将其转换为 RAG-Anything 的 content_list 格式并插入检索系统。这一教程对希望实现多模态 RAG 的开发者非常实用,它展示了如何将非文本内容纳入检索增强生成流程,从而提升问答系统对复杂文档的理解能力。建议读者跟随教程在 Colab 中实际操作,并尝试替换为自己的数据集以测试效果。

阿里巴巴 Page Agent:用自然语言通过 DOM 控制网页的 GUI Agent

阿里巴巴推出的 Page Agent 是一个运行在网页中的 JavaScript GUI Agent,能够通过读取实时 DOM 来理解页面,并根据自然语言指令执行点击和输入操作,无需截图或多模态模型。这一工具值得关注,因为它提供了一种轻量级的网页自动化方案,降低了开发门槛,且无需后端改造。影响对象包括需要自动化网页交互的开发者、测试人员和 RPA 用户。要使用它,可以在目标页面中注入 Page Agent 脚本,然后通过自然语言接口发送指令。

06 月 30 日 2026-06-30 快讯

Anthropic Claude Sonnet 5 发布:编程能力逼近 Opus,性价比更优

Anthropic 发布了 Claude Sonnet 5,在代理编程基准测试中缩小了与 Opus 4.8 的差距,同时保持了 Sonnet 系列更低的 API 价格。这意味着开发者现在可以用更低的成本获得接近顶级模型的编程能力。这一更新值得关注,因为它直接影响了 AI 编程工具的成本效益比,尤其对于高频调用 API 的团队。影响的人群包括使用 Claude 进行代码生成和调试的开发者。建议开发者对比 Sonnet 5 和 Opus 4.8 在自身项目中的实际表现,结合 token 消耗计算成本,选择最适合的模型。

06 月 29 日 2026-06-29 快讯

Top 6 No-Code Tools for AI Engineers:零代码构建 RAG 与多智能体工作流

MarkTechPost 文章盘点了六款面向 AI 工程师的无代码工具,这些工具允许用户无需编写代码即可构建企业级 RAG 系统、设计多智能体工作流或微调大语言模型。核心结论是,无代码平台正在大幅降低 AI 应用的开发门槛,使非技术背景人员也能快速部署智能应用。该盘点值得关注的原因在于,它反映了 AI 工程化领域的一个重要趋势,即通过可视化与配置化方式加速开发,直接影响到产品经理、业务分析师以及希望快速验证 AI 方案的创业者。下一步,读者可根据自身需求,从列表中选择一个工具进行试用,例如搭建一个简单的 RAG 问答系统,以评估其易用性与功能完整性。

EverOS:开源 Markdown 优先的 AI 代理记忆运行时

EverOS 是一个本地优先的记忆运行时,由 EverMind 开源,采用 Apache 2.0 许可。它将 AI 代理的记忆存储为纯 Markdown 文件,通过 SQLite 和 LanceDB 索引,结合混合 BM25 和向量检索,支持多模态输入和自我进化的技能。该工具值得关注,因为它提供了一种全新的代理记忆管理方式,强调可读性和可移植性,对构建长期运行的 AI 代理系统有重要参考价值。受影响最大的群体是 AI 代理开发者和研究者,他们可以利用 EverOS 构建具有持久记忆的智能体。要验证其效果,可以下载代码,运行示例,观察其记忆检索和技能进化能力。

06 月 23 日 2026-06-23 快讯

Mistral OCR 4:支持引用就绪的结构化输出,适用于 RAG 与企业搜索

一句话结论:Mistral OCR 4 从纯文本提取升级为结构化文档输出,每个块返回边界框、分类和置信度分数,支持 170 种语言。原始信息明确发生了什么:Mistral AI 发布了 OCR 4,该模型通过单一 API 端点提供结构化输出,包括每页和每词的置信度,并可在自托管容器中运行。为什么值得关注:OCR 4 的引用就绪输出直接服务于 RAG、代理和企业搜索管道,减少了后处理工作量,同时 170 种语言支持使其具有广泛的适用性。影响谁:主要影响需要文档解析的 RAG 系统开发者、企业搜索工程师以及需要高精度 OCR 的文档处理团队。下一步怎么验证或使用:开发者可申请 Mistral OCR 4 API 访问,测试其对多语言文档的结构化提取效果,重点验证边界框和置信度分数在 RAG 管道中的集成效果。

Prime Intellect 发布 prime-rl 0.6.0:开源框架支持万亿参数 MoE 模型的异步强化学习训练

一句话结论:prime-rl 0.6.0 是一个开源框架,专为万亿参数 MoE 模型设计,支持异步强化学习训练,并在 28 个 H200 节点上实现了高效训练。原始信息明确:Prime Intellect 发布了该框架,成功训练 GLM-5 在 SWE 任务上达到 131k 序列长度,步时间低于 5 分钟,包含 256 个 rollout,并采用了 FP8 推理、宽专家并行等优化。为什么值得关注:它展示了在超大规模模型上应用强化学习的可行性,为训练更智能的代理模型提供了基础设施。影响谁:主要影响从事大模型训练、强化学习研究的 AI 研究员、工程师以及需要训练超大规模 MoE 模型的组织。下一步验证或使用:研究者可从 GitHub 获取源码,按照文档配置硬件环境,尝试复现 GLM-5 的训练实验,或基于框架自定义训练任务。

06 月 20 日 2026-06-20 快讯

TimeCopilot:基于基础模型与自动异常检测的预测管线构建指南

一句话结论:TimeCopilot提供了一个端到端的时间序列预测工作流,集成基础模型和自动异常检测。原始信息显示,该指南使用真实航空乘客数据和合成季节序列进行演示,评估了统计模型、基础模型和可选的GPU模型,通过滚动交叉验证和多种误差指标生成概率预测、可视化未来趋势并标记异常点。它值得关注,因为它将基础模型与传统时间序列方法结合,并提供了完整的评估框架,降低了预测任务的技术门槛。影响人群包括数据科学家、业务分析师以及需要时间序列预测的行业从业者。下一步,读者可按照指南步骤,使用自己的时间序列数据运行TimeCopilot管线,对比不同模型的预测效果,并利用异常检测功能发现数据中的异常模式。

06 月 16 日 2026-06-16 快讯

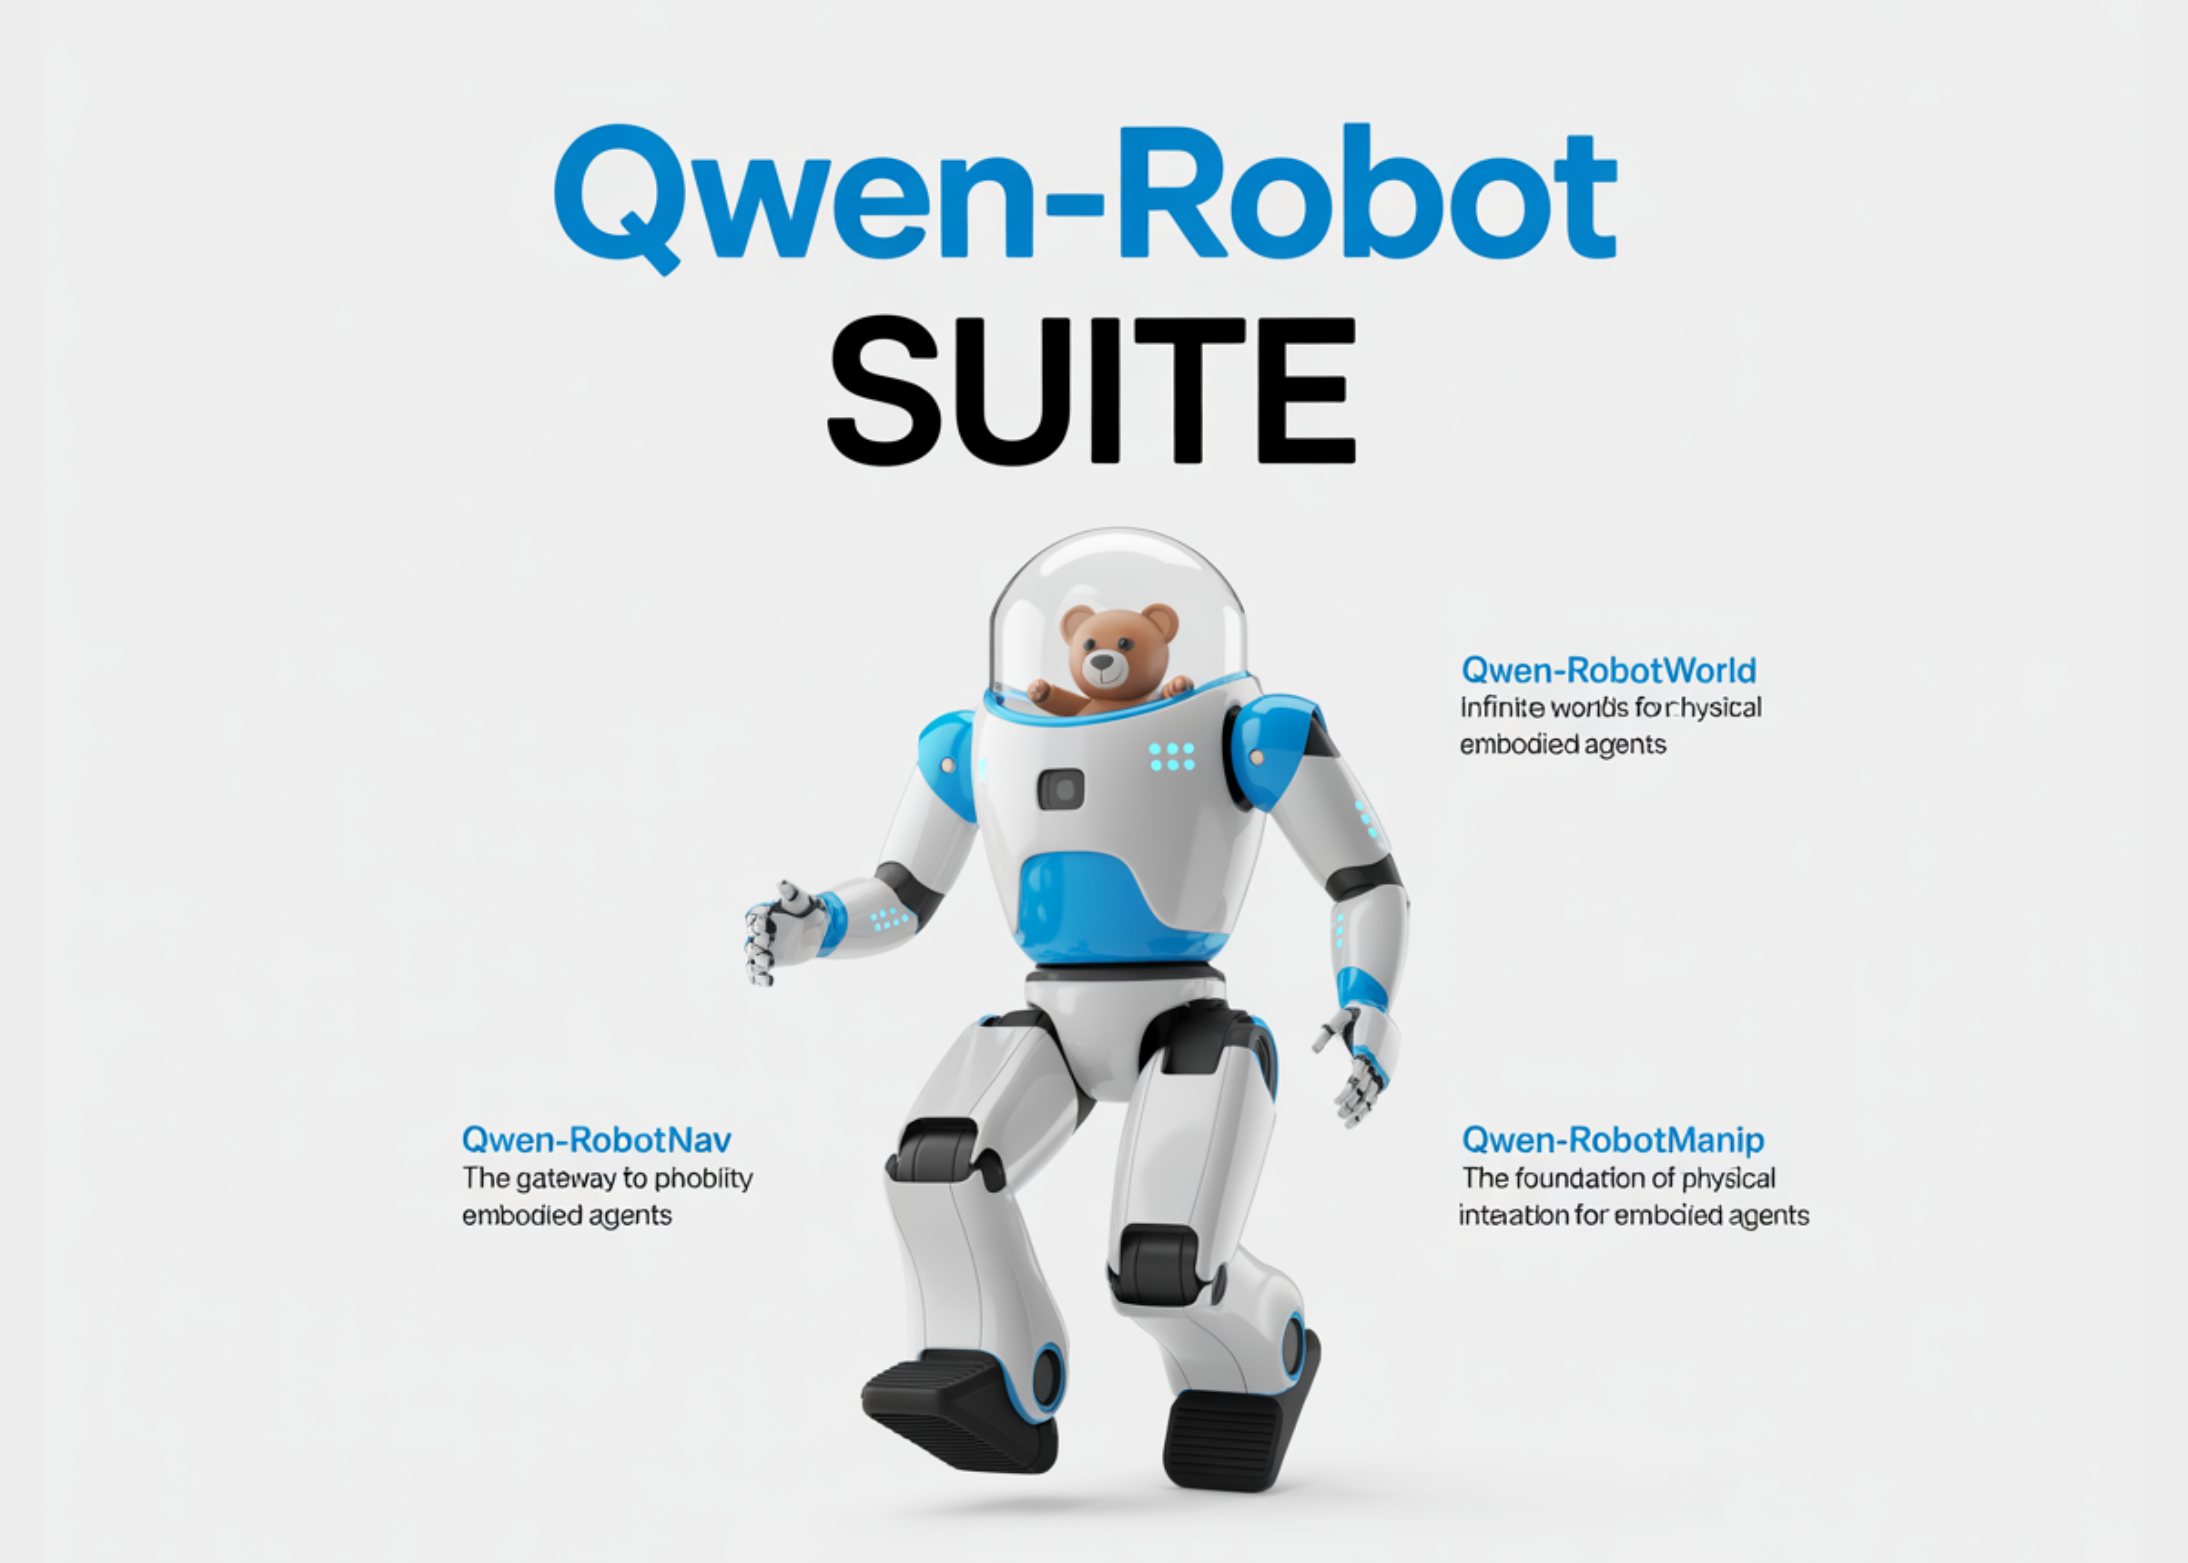
Qwen-RobotSuite:通义千问团队发布三款具身智能模型,覆盖操作、世界建模与导航

一句话结论:Qwen团队发布了三款具身智能模型,分别用于机械臂操作、视频世界建模和机器人导航。原始信息显示Qwen-RobotSuite包含三个模型:RobotManip,一个基于Qwen3.5-4B的视觉-语言-动作模型,用于操作任务;RobotWorld,一个语言条件视频世界模型,采用60层MMDiT架构;RobotNav,一个基于Qwen3-VL的导航模型,提供2B、4B和8B三种尺寸。文章详细介绍了每个模型的架构、数据管道和基准测试结果。这值得关注,因为这是通义千问团队在具身智能领域的系统性布局,三个模型覆盖了机器人核心能力,且基于成熟的大模型架构。影响对象主要是机器人研究者、具身智能开发者以及自动化领域的工程师。下一步建议研究人员阅读论文原文,了解模型架构细节和基准测试表现,并关注后续是否开放模型权重或API,以便在仿真或真实环境中进行验证。

06 月 15 日 2026-06-15 快讯

Z.ai 发布 GLM-5.2:100 万 token 上下文窗口,两种思考力度,无基准测试

一句话结论:Z.ai 发布了 GLM-5.2,主打 100 万 token 的可用上下文窗口和 High/Max 两种思考力度,但发布时未附带基准测试结果。原始信息明确:该模型于 2026 年 6 月 13 日上线,覆盖所有 GLM Coding Plan 层级,支持通过 Anthropic 兼容端点集成到 Claude Code、Cline 和 OpenClaw 中,MIT 开源权重承诺下周发布。为什么值得关注:100 万 token 上下文窗口是当前业界最高之一,适合处理超长文档或复杂对话,但缺乏基准测试让性能评估存在不确定性。影响谁:主要影响需要处理超长上下文的开发者、研究长文档理解的团队以及关注 GLM 系列进展的用户。下一步怎么验证或使用:你可以通过 GLM Coding Plan 访问该模型,输入一份超长文档(如整本书),测试其上下文理解和摘要能力,同时关注下周开源权重的发布以便本地部署。

06 月 13 日 2026-06-13 快讯

QwenPaw Agent工作区构建教程:自定义技能、模型提供商与API测试

一句话结论:一篇教程详细介绍了如何构建QwenPaw Agent工作区,包括自定义技能、模型提供商配置和流式API测试。原始信息是MarkTechPost发布的教程,指导用户安装和初始化QwenPaw,配置工作目录、认证和可选的模型提供商,创建结构化工作区和本地知识文件,并启动控制台和流式API测试。这件事值得关注,因为QwenPaw提供了一个实用的Agent开发环境,教程降低了构建AI助手的门槛,尤其适合希望快速原型验证的开发者。受影响的主要是AI Agent开发者、RAG系统构建者和模型测试人员。下一步建议读者按照教程步骤,在Colab或本地环境中搭建QwenPaw工作区,配置自定义技能和知识文件,然后通过控制台和API测试Agent的响应效果,验证工作区的实用性和扩展性。

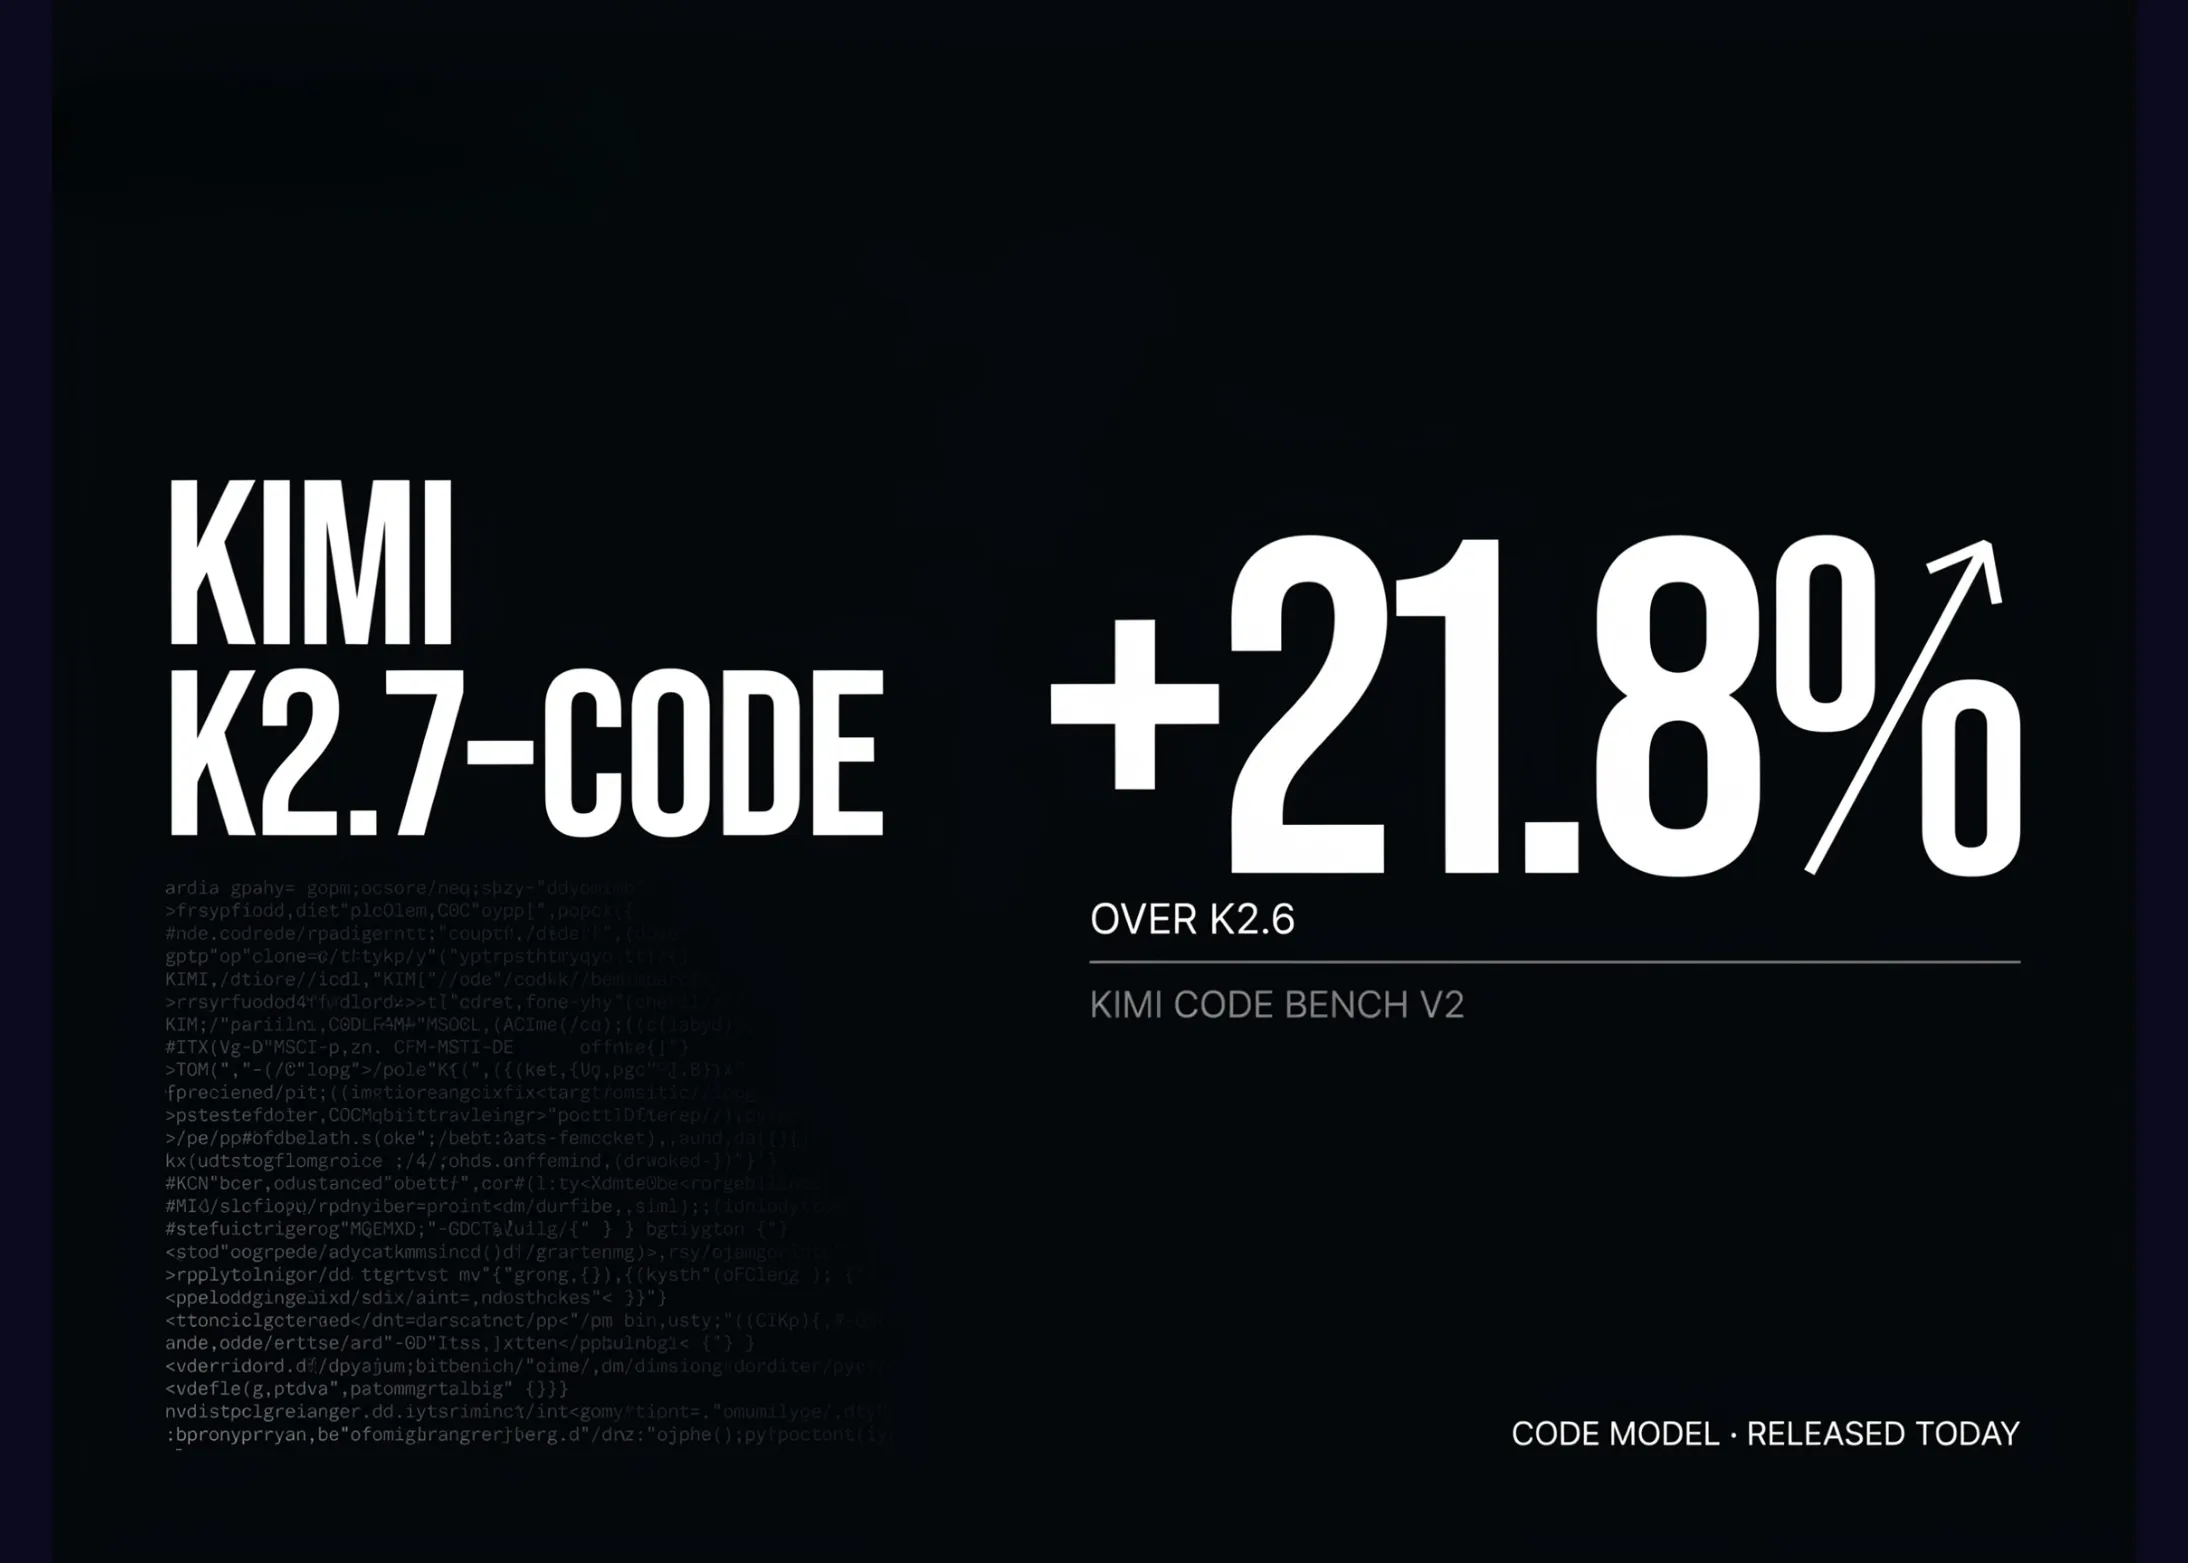
Moonshot AI开源Kimi K2.7-Code:编码模型性能提升21.8%

一句话结论:Moonshot AI开源了Kimi K2.7-Code编码模型,在多个基准测试上显著超越前代。原始信息明确发生了什么:该模型基于Kimi K2.6构建,拥有256K上下文窗口,推理token使用量降低约30%。在Kimi Code Bench v2上提升了21.8%,并在其他五个基准测试上也有提升。模型采用Modified MIT许可证开源,可通过Kimi API和Kimi Code使用。为什么值得关注:编码模型是AI辅助编程的核心,Kimi K2.7-Code在性能和效率上的提升,意味着开发者可以用更低的成本获得更好的代码生成效果。影响谁:主要影响AI辅助编程工具的用户、开发者以及研究编码模型的团队。下一步怎么验证或使用:开发者可通过Kimi API调用该模型,或在Kimi Code中体验,对比其与K2.6在代码生成、调试等任务上的表现。

06 月 08 日 2026-06-08 快讯

Google Research 为 Gemini Enterprise Agent 平台引入 Agentic RAG 框架

一句话结论:Google Research 在 Gemini Enterprise Agent 平台中新增了 Agentic RAG 框架,通过 Sufficient Context Agent 实现多跳查询的自动补全,将事实准确性提升高达 34%。该框架的核心创新在于,当面对需要多源信息才能回答的复杂查询时,Agent 会主动进行多次检索,直到收集到足够支撑答案的上下文为止,而非像传统 RAG 那样仅做单次检索。值得关注的原因是,多跳查询是 RAG 系统长期面临的难点,该方案从 Agent 层面实现了检索策略的自动优化,显著提升了复杂问题的回答质量。主要影响 RAG 应用开发者、企业知识库构建者以及需要处理复杂查询的 AI 系统。下一步可以关注 Google 发布的详细技术报告,了解其实现细节,并评估是否能在自建 RAG 系统中借鉴类似策略。

06 月 02 日 2026-06-02 快讯

Qwen3.7-Plus:阿里通义千问多模态智能体模型上线百炼平台

一句话结论:阿里 Qwen 团队发布 Qwen3.7-Plus,这是一个具备视觉理解、深度推理、工具调用和自主迭代能力的多模态智能体模型,已在百炼平台上线。原始信息明确:该模型不仅能理解图像和视频,还新增了自我编程和工具调用功能,标志着从单一语言模型向全能型智能体的进化。为什么值得关注:多模态与自主迭代能力的结合意味着模型可以主动调用外部工具、编写代码并自我修正,大幅扩展了 AI 在复杂任务中的应用边界。影响谁:使用阿里云百炼平台的企业开发者、AI 应用构建者,以及需要视觉理解与自动化推理能力的行业用户。下一步验证:登录百炼平台,在模型列表中查找 Qwen3.7-Plus,尝试上传图片或视频,测试其视觉问答和工具调用功能。